
get_more_tools pour demander de nouvelles capacités et envoyer des retours. Vous n’appelez pas ces outils vous-même. Après avoir configuré AppSignal MCP, vous posez une question à votre agent, par exemple : « Quelles actions sont les plus lentes en production actuellement ? » Il choisit l’outil et renseigne les paramètres. Consultez cette page pour vérifier si une capacité existe, ou quel paramètre nommer lorsque votre agent se trompe.
Pour des exemples d’invites qui combinent plusieurs outils, consultez les flux de travail AppSignal MCP.
Référence des outils
Les outils sont classés du plus utilisé au moins utilisé :
Par domaine produit :
- Découverte d’applications:
get_app_resources,get_applications - Incidents d’erreur:
get_exception_incidents,get_incident,update_incidents,manage_note - Performance:
get_traces,get_performance - Anomaly detection:
get_anomaly_incidents,get_triggers,manage_trigger - Check-ins:
get_check_in_triggers,manage_check_in_trigger - Uptime monitoring:
manage_uptime_monitor - Journalisation:
get_log_lines,manage_log_line_action - Métriques:
get_metrics_list,get_metrics_timeseries,get_metric_tags,get_metric_names,discover_metrics - Tableaux de bord:
manage_dashboard,create_dashboard_visual,update_dashboard_visual
app_name et app_environment, comparés sans tenir compte de la casse. Si aucune application ne correspond, l’outil suggère les noms les plus proches afin que l’agent puisse réessayer.
Les champs de métriques ne tiennent pas compte de la casse non plus : metric_type et field acceptent aussi bien P90 que p90.
Chaque outil prend également une chaîne context, dans laquelle l’agent indique pourquoi il effectue l’appel. Les agents la renseignent généralement, c’est pourquoi les tableaux l’omettent.
manage_trigger, manage_log_line_action, manage_check_in_trigger et manage_uptime_monitor prennent un paramètre action requis qui choisit l’opération. Dans leurs tableaux, oui (upsert) signale un champ requis à chaque upsert. Oui (création) signale un champ requis uniquement lorsque l’upsert crée quelque chose.
get_traces
Interrogez les traces de performance et d’erreur, inspectez les arbres de spans et consultez les détails des spans.
Pour ajouter une note à une action de trace de performance, utilisez manage_note.
Prend en charge deux types de traces :
- Traces de performance — identifiées par le namespace et
action_name. Utilisez-les pour enquêter sur des requêtes lentes. - Traces d’erreur — identifiées par digest. Obtenez le digest depuis
get_incidentouget_exception_incidents, puis utilisez-le ici pour voir les traces d’erreur réelles.
- Mode liste — trouvez des traces et obtenez les ID de trace. Fournissez le namespace +
action_name, oudigest. Ajouteztagspour ne garder que les traces dont les valeurs de tag correspondent, par exemple un tag personnaliséuser_id. - Mode arbre — passez un
trace_idpour voir tous les spans sous forme d’arbre compact, ainsi que les métadonnées du span racine et une répartition de la durée. La répartition indique le temps propre par catégorie : ce sur quoi les spans de chaque catégorie ont réellement travaillé, plutôt que d’attendre un enfant. Un ID de trace fonctionne seul : vous n’avez pas besoin du namespace et du nom d’action pour en rechercher un. - Mode détail de span — passez
trace_idetspan_idpour les attributs de span complets, les événements et les informations de ressource. Les valeurs d’attribut longues sont tronquées à 500 caractères. Le texte des requêtes de base de données fait exception et est transmis en entier jusqu’à 10 000 caractères. Les données sensibles que vous demandez avecinclude_sensitivesont également transmises en entier, comme les variables GraphQL dans les paramètres de requête.
get_exception_incidents
Listez et recherchez les exceptions et erreurs AppSignal.
Utilisez-le pour obtenir un aperçu des exceptions récentes, rechercher dans une période, trouver des incidents par état, ou vérifier quels incidents nécessitent attention. Retourne 50 incidents par page.
Pour les invites qui demandent à votre agent les nouvelles erreurs, consultez Vérifier ce qu’un déploiement a cassé.
get_metrics_list
Obtenez une valeur agrégée pour une métrique sur une plage horaire.
Retourne une seule valeur agrégée plutôt qu’une série chronologique point par point. Utile pour les vues récapitulatives.
Comptage des lignes de journal :
Transmettez
log_metrics comme metric_name, avec le type de métrique gauge, pour compter des lignes de journal ou agréger un champ de journal sans récupérer les lignes. AppSignal calcule le résultat à partir de vos lignes de journal stockées et renvoie une ligne par valeur de group_by sur l’ensemble de la plage horaire. Décrivez la requête dans tags :
Cette requête compte les lignes de journal
signup d’une source, par sévérité :
get_metrics_timeseries, qui renvoie une valeur par intervalle de temps. Chaque requête parcourt vos lignes de journal stockées : pour un comptage que vous interrogerez souvent, par exemple sur un tableau de bord ou dans un déclencheur, créez plutôt une action de ligne de journal de métriques.
get_metrics_timeseries
Obtenez une série chronologique pour une métrique dans l’application donnée.
Retourne les valeurs d’une métrique sur une plage horaire, pour un type de métrique et une combinaison de tags. Les valeurs des tags prennent en charge la correspondance par caractère générique avec *.
Dans les hôtes qui prennent en charge l’extension MCP Apps, comme Claude et ChatGPT, le résultat s’affiche comme un graphique AppSignal interactif, construit à partir des mêmes composants que vos tableaux de bord. Dans les clients texte seul, comme Claude Code, Cursor et Codex, l’assistant lit les valeurs et répond avec ses propres mots.
Le résultat contient :
- Un résumé : la plage horaire et l’intervalle et, pour chaque série, son unité, son pic, son minimum, sa moyenne et les périodes sans données.
- Un tableau CSV des valeurs : une ligne par intervalle. Un intervalle sans données est un champ vide, jamais
0, pour qu’il ne ressemble pas à une chute à zéro. L’intervalle encore en cours est marquépartial. - Des données structurées, pour les clients qui exécutent du code. Un intervalle sans données vaut
null.
resolution demande des valeurs par minute, par heure ou par jour. Les valeurs par minute ne fonctionnent que pour une plage de 12 heures ou moins qui commence dans les 48 dernières heures. Le résultat indique l’intervalle utilisé.
Consultez Vérification d’une métrique dans le temps pour des exemples de prompts.
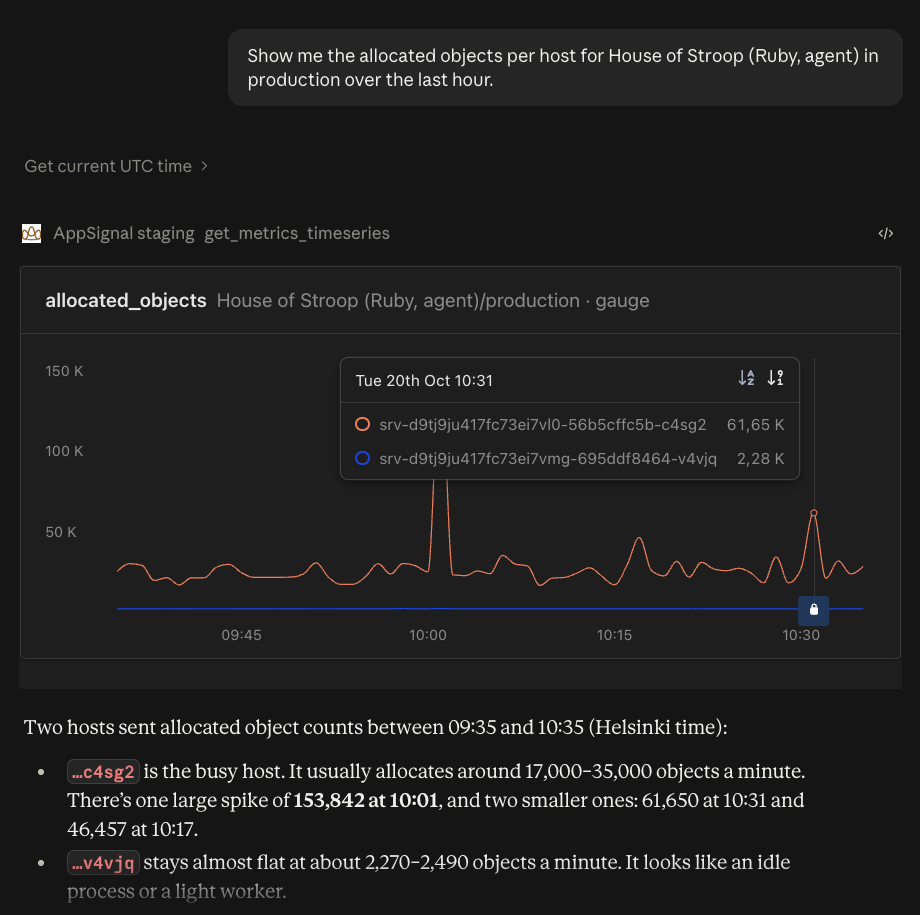
Un appel à get_metrics_timeseries s'affichant comme un graphique AppSignal dans Claude, suivi du résumé des données par Claude.
get_incident
Obtenez des informations détaillées sur un incident AppSignal.
Retourne l’état actuel, l’attribution, la première et la dernière occurrence, les messages d’erreur, les traces de pile ou les détails de l’alerte d’anomalie. Prend en charge les incidents d’exception, d’anomalie et de performance. Pour un incident de performance, retourne aussi la durée moyenne et une répartition par déploiement.
La réponse liste toujours les notes de l’incident, avec l’ID de chacune. Transmettez cet ID à manage_note pour modifier une note que vous avez rédigée.
get_log_lines
Interrogez les lignes de journal en utilisant la syntaxe d’expression d’AppSignal.
Prend en charge la correspondance exacte, contient, la négation, les comparaisons numériques, la logique booléenne et les attributs imbriqués. Retourne jusqu’à 100 lignes par appel, du plus récent au plus ancien par défaut. Pour les grandes plages horaires, divisez en plusieurs appels et itérez vers l’avant.
Pour compter des lignes de journal ou agréger un champ de journal, utilisez plutôt get_metrics_list avec log_metrics.
Un appel peut couvrir au maximum la fenêtre de requête de votre compte, qui dépend de votre volume de logs. Une plage plus longue est ajustée pour tenir dans cette fenêtre. Vous obtenez la partie la plus récente par défaut, ou la plus ancienne avec order: asc. La réponse indique ce qu’elle a retourné et quelle plage horaire demander ensuite.
Dans la sortie texte, chaque ligne commence par un aperçu de 120 caractères de son message. Un message plus long obtient une ligne Message distincte avec le texte complet, limité à 2 000 caractères.
Syntaxe de requête :
Champs disponibles :
severity, hostname, group, message et tout attribut personnalisé.
get_app_resources
Découvrez les ressources disponibles dans une application AppSignal — namespaces, tableaux de bord, utilisateurs, notifieurs, sources de journaux, vues de journal, actions de ligne de journal, marqueurs de déploiement et moniteurs de disponibilité.
Particulièrement utile lors de la configuration de déclencheurs, de l’attribution d’incidents ou de la compréhension de la structure d’une application.
La section
deploy_markers retourne jusqu’à 100 déploiements récents, chacun avec sa révision complète et la plage horaire pendant laquelle il était actif. Restreignez-la avec deploy_marker_namespace ou deploy_marker_revision. Pour trouver les erreurs qu’un déploiement a introduites, passez sa révision à get_exception_incidents avec new_only: true. Sans new_only, vous obtenez toutes les erreurs signalées dans ce déploiement. Cela inclut celles observées pour la première fois dans un déploiement antérieur.
La section uptime_monitors liste chaque URL surveillée avec son ID, ses régions, son warm-up, sa vérification de corps de réponse, ses notifieurs et les noms des en-têtes de requête. Les valeurs des en-têtes ne sont jamais affichées, car elles peuvent contenir des identifiants. Pour créer, modifier ou supprimer un moniteur, utilisez manage_uptime_monitor. La disponibilité elle-même n’est pas stockée — elle est calculée à partir de métriques, donc interrogez le compteur uptime_monitor_error_count avec get_metrics_timeseries pour la calculer. Pour un détail par phase, interrogez uptime_monitor_timing avec un tag phase. Voir temps de requête.
get_applications
Obtenez toutes les applications AppSignal auxquelles l’utilisateur a accès.
Retourne les applications au format app_name/app_environment. Utilisez-le lorsque vous avez besoin de la liste complète. Les autres outils n’en ont pas besoin au préalable : lorsqu’un nom ne correspond pas, ils suggèrent les applications les plus proches.
Aucun paramètre spécifique à la tâche en dehors de context.
get_anomaly_incidents
Listez et recherchez les alertes de Anomaly detection AppSignal.
Retourne 50 alertes par page, y compris les horodatages et valeurs pour chaque alerte.
get_performance
Aperçu des performances : traces de performance basées sur des échantillons et actions lentes à partir des traces.
Pour les applications Ruby et Elixir standard, retourne les traces de performance basées sur des échantillons. Pour les applications qui envoient également des traces OpenTelemetry, retourne en plus une liste classée d’actions avec la durée moyenne, le débit et le taux d’erreur. Les applications en cours de migration vers OpenTelemetry peuvent retourner les deux.
Le débit des actions OpenTelemetry est une moyenne par minute sur la plage horaire demandée. Le nombre total de requêtes sur cette plage est affiché à côté.
Outils de suivi : utilisez get_incident pour inspecter un incident de performance spécifique, get_traces pour récupérer des traces pour une action lente, et update_incidents pour modifier l’état, la gravité ou les attributions.
get_metric_tags
Obtenez les tags et le type de métrique (Gauge, Counter, etc.) pour une métrique spécifique.
Utilisez les résultats pour construire des requêtes valides avec get_metrics_timeseries et get_metrics_list.
update_incidents
Mettez à jour en masse les incidents d’une application AppSignal.
Utilisez-le pour modifier l’état d’incidents, mettre à jour la gravité ou attribuer et désattribuer des membres d’équipe sur plusieurs incidents à la fois. Utilisez get_app_resources avec sections: ["users"] pour trouver les ID utilisateur pour l’attribution.
get_metric_names
Obtenez les noms de toutes les métriques pour l’application donnée.
Retourne les noms des métriques sous forme de chaîne séparée par des virgules. Utilisez-les comme entrée pour get_metric_tags, get_metrics_timeseries et get_metrics_list.
get_triggers
Listez les déclencheurs de Anomaly detection pour une application AppSignal.
Retourne les déclencheurs actifs (non archivés) avec leur configuration complète — conditions, notifieurs et liens vers les tableaux de bord. Utilisez-le pour trouver les ID de déclencheur avant d’appeler manage_trigger.
discover_metrics
Découvrez les catégories de métriques disponibles et leurs métriques pour la surveillance.
Utilisez-le pour obtenir un aperçu de ce que vous pouvez surveiller, ou pour explorer une catégorie spécifique. Accepte également une référence dashboard:<dashboard_id> pour afficher les métriques utilisées dans un tableau de bord spécifique.
La catégorie uptime_monitoring couvre les vérifications échouées, le temps de réponse, le nombre de jours avant l’expiration du certificat SSL, et uptime_monitor_timing, le temps pris par chaque étape d’une vérification. Pour obtenir toutes les étapes à la fois, interrogez uptime_monitor_timing avec get_metrics_timeseries et * comme valeur de phase. get_metrics_list ne renvoie rien pour *, transmettez donc une seule phase.
manage_trigger
Créer, mettre à jour ou archiver un déclencheur de Anomaly detection.
Les déclencheurs sont immuables. Lorsque vous mettez à jour un déclencheur, AppSignal archive celui existant, ferme toutes ses alertes et incidents, et en crée un remplaçant. Fournissez tous les champs pour les opérations de création et de mise à jour.
Utilisez get_metric_names et get_metric_tags pour découvrir les métriques et champs disponibles. Utilisez get_app_resources(sections: ["notifiers"]) pour trouver les ID de notifieur.
Cet outil remplace l’ancien flux
archive_trigger. L’ancien nom continue de fonctionner comme alias de rétrocompatibilité, mais manage_trigger est l’outil principal.get_check_in_triggers
Répertorie les moniteurs check-in (cron et heartbeat), ou inspecte un moniteur avec ses exécutions récentes.
Les deux outils check-in couvrent les mêmes moniteurs que process monitoring : les moniteurs cron, qui attendent une exécution selon un calendrier, et les moniteurs heartbeat, qui attendent un signal continu.
Utilisez ceci pour voir quels jobs ou services planifiés sont censés se signaler, vérifier s’ils sont à l’heure, ou trouver l’ID d’un moniteur avant de le mettre à jour.
manage_check_in_trigger
Créer, mettre à jour ou supprimer un moniteur check-in.
Contrairement aux déclencheurs de Anomaly detection, les moniteurs check-in sont mis à jour sur place. Lorsque vous en mettez un à jour, les champs omis conservent leurs valeurs actuelles.
manage_uptime_monitor
Créer, mettre à jour ou supprimer un moniteur de disponibilité. Pour lister les moniteurs avec leurs paramètres, utilisez get_app_resources avec la section uptime_monitors.
Un moniteur de disponibilité est une URL qu’AppSignal vérifie chaque minute depuis une ou plusieurs régions. AppSignal vous alerte lorsque l’URL est inaccessible.
Les mises à jour modifient le moniteur sur place : les champs omis conservent leurs valeurs actuelles. regions, notifier_ids et headers remplacent la liste actuelle au lieu de s’y ajouter.
Pour des invites qui configurent et interrogent un moniteur, consultez Configurer un moniteur de disponibilité.
manage_log_line_action
Créer, mettre à jour, réorganiser ou supprimer une action de ligne de journal.
Les actions de ligne de journal s’exécutent pendant l’ingestion des journaux, dans l’ordre que vous définissez. Il existe trois types :
- filter — écarte les lignes de journal correspondantes afin qu’elles ne soient jamais stockées ni traitées
- trigger — déclenche des alertes et incidents lorsque la requête correspond
- metrics — extrait des métriques de compteur, jauge ou distribution à partir des lignes de journal correspondantes
Cet outil remplace les anciens flux
reorder_log_line_actions et delete_log_line_action. Ces noms continuent de fonctionner comme alias de rétrocompatibilité, mais manage_log_line_action est l’outil principal.manage_note
Créez ou mettez à jour une note sur un incident AppSignal ou sur une action de trace de performance. Markdown est pris en charge.
Utilisez ceci pour ajouter des commentaires, mises à jour de statut, conclusions d’enquête ou étapes de résolution. Identifiez la cible avec number pour un incident, ou avec namespace et action_name pour une action de trace de performance. Fournir les deux renvoie une erreur.
Une note sur une action de trace de performance est partagée par toutes les traces de cette action. Elle reste après l’expiration des données de trace de l’action. Une note sur un incident de performance est stockée sur l’action de trace de l’incident, pas sur l’incident lui-même. Elle reste disponible après la fermeture de l’incident. Consultez la documentation de la page des traces pour savoir où ces notes apparaissent.
Mentionnez un ticket ou une pull request GitHub dans une note d’incident pour le lier : son URL, ou la forme abrégée owner/repo#123. Cela nécessite que l’application ait GitHub configuré. La référence doit pointer vers un dépôt de la même organisation GitHub. La liaison GitHub ne s’applique pas aux notes sur les actions de trace.
Une note d’incident lie aussi les tickets Linear, Jira et GitLab, mais uniquement par leur URL complète, comme https://linear.app/acme/issue/ENG-42. Les formes abrégées ne fonctionnent pas pour eux. Vous devez avoir configuré vous-même l’intégration de ce tracker pour l’application, car AppSignal recherche le ticket avec votre compte. Consultez Linear, Jira et GitLab pour savoir ce qui est lié.
Cet outil s’appelait auparavant
manage_incident_note, et avant cela create_incident_note. Les deux anciens noms fonctionnent toujours comme alias, afin que les invites et configurations existantes continuent de fonctionner.manage_dashboard
Créer ou mettre à jour un tableau de bord AppSignal.
Cet outil gère uniquement les métadonnées du tableau de bord (titre et description). Utilisez create_dashboard_visual et update_dashboard_visual pour ajouter des graphiques.
MCP ajoute et met à jour, mais ne supprime pas. Pour supprimer un graphique ou un tableau de bord entier, ouvrez les tableaux de bord de votre application sur AppSignal.
create_dashboard_visual
Ajoutez un nouveau graphique à un tableau de bord existant. Deux types de visuels sont disponibles :
timeseries(par défaut) — un graphique en ligne ou en aire traçant une ou plusieurs métriques au fil du temps.number— une tuile Big Number affichant une seule métrique agrégée, utile pour un total, la dernière lecture ou une moyenne en un coup d’œil.
discover_metrics ou get_metrics_list pour trouver d’abord les métriques disponibles.
Ces paramètres s’appliquent aux deux types de visuels :
Ces paramètres s’appliquent uniquement aux visuels
timeseries :
Ces paramètres s’appliquent uniquement aux visuels
number :
Une tuile Big Number prend une métrique et une agrégation sur la plage horaire sélectionnée du tableau de bord. Son nom de métrique et ses tags ne peuvent pas contenir de caractère générique (
*), car la tuile affiche une seule série. Demandez-la en langage naturel :
Text
create_dashboard_visual :
update_dashboard_visual
Mettez à jour un graphique existant sur un tableau de bord. Cela fonctionne à la fois pour les visuels timeseries et Big Number — le type est lu depuis le visuel existant, vous n’avez donc pas besoin de passer type.
Tous les champs sont facultatifs sauf les identifiants, et les champs non spécifiés conservent leurs valeurs actuelles. Passer metrics ou metric remplace toute la définition de métrique de ce visuel plutôt que de la fusionner.
Sortie structurée
Six outils renvoient des données structurées en plus de leur sortie texte. Chacun déclare un schéma de sortie, de sorte que les clients MCP qui exécutent du code peuvent lire des champs typés au lieu d’analyser le texte. La sortie texte est toujours renvoyée, donc les agents qui la lisent fonctionnent de la même manière.app est l’application sous la forme app_name/app_environment, par exemple Shop/production.
Dans get_log_lines, chaque ligne a id, timestamp, severity, group, hostname, source_id, message et attributes. message contient le message complet, limité à 2 000 caractères. attributes contient les attributs JSON de la ligne sous forme d’objet, ou null lorsqu’ils ne forment pas un objet JSON. full_page vaut true lorsque l’appel a renvoyé autant de lignes que sa limite. continuation contient le start et le end à demander ensuite lorsque la plage a été réduite pour tenir dans votre fenêtre de requête. Sinon, il vaut null. url renvoie vers la même recherche sur la page Logs.
Outils de lecture et d’écriture
Chaque outil lit uniquement vos données ou peut les modifier, et son nom indique lequel : les outilsget_ et discover_ ne font que lire, tandis que les outils create_, update_ et manage_ écrivent. La suppression se trouve à l’intérieur des outils manage_ plutôt que dans des outils qui lui sont propres : manage_log_line_action supprime une action, manage_check_in_trigger et manage_uptime_monitor suppriment un moniteur, et manage_trigger archive un déclencheur. C’est cette répartition que les clients MCP utilisent pour regrouper les outils, afin que vous puissiez configurer dans votre agent quels outils autoriser, lesquels approuver au cas par cas, et lesquels bloquer.
Permissions des tokens
Chaque token MCP est limité aux applications que vous sélectionnez, ou à toutes les applications, y compris celles créées ultérieurement, ainsi qu’aux outils que vous exposez sur ce token. Si vous voulez une configuration plus restreinte pour un agent, c’est ici que vous la limitez. Par exemple, vous pourriez exposer uniquementget_applications, get_app_resources et get_exception_incidents pour un agent de tri des incidents, ou get_log_lines et manage_log_line_action pour le travail d’ingestion de journaux.
Vous pouvez également configurer un token pour exposer automatiquement les nouveaux outils au fur et à mesure qu’ils sont ajoutés par la suite. Pour connaître les étapes de création, consultez Authentification.
Un outil manquant ?
En complément des outils ci-dessus, AppSignal MCP exposeget_more_tools, un outil de découverte et de retour d’expérience. Il remplit deux fonctions :
- Journaliser une demande pour une capacité que vous n’avez pas trouvée
- Signaler comment une tâche ou un appel d’outil s’est déroulé
get_more_tools prend ces paramètres :
La plupart des agents n’y auront pas recours d’eux-mêmes, il faut donc demander explicitement :
« Utilise l’outil AppSignal
get_more_tools pour demander un moyen d’exporter en masse les incidents au format CSV. »
Ou, lorsqu’une tâche a partiellement fonctionné :
« Utilise l’outil AppSignal get_more_tools pour signaler que get_log_lines a trouvé les bons journaux, mais qu’il m’a fallu une seconde étape pour les résumer. »