
get_more_tools para pedir novas capacidades e enviar feedback. Você não chama essas ferramentas diretamente. Depois de configurar o AppSignal MCP, você pergunta ao seu agente, por exemplo: “Quais actions estão mais lentas em produção agora?” Ele escolhe a ferramenta e preenche os parâmetros. Consulte esta página para verificar se uma capacidade existe, ou qual parâmetro nomear quando o seu agente errar.
Para exemplos de prompts que combinam ferramentas, veja os workflows do AppSignal MCP.
Referência de ferramentas
As ferramentas estão listadas da mais usada para a menos usada:
Por área de produto:
- Descoberta de apps:
get_app_resources,get_applications - Incidentes de erro:
get_exception_incidents,get_incident,update_incidents,manage_note - Performance:
get_traces,get_performance - Anomaly detection:
get_anomaly_incidents,get_triggers,manage_trigger - Check-ins:
get_check_in_triggers,manage_check_in_trigger - Uptime monitoring:
manage_uptime_monitor - Logging:
get_log_lines,manage_log_line_action - Métricas:
get_metrics_list,get_metrics_timeseries,get_metric_tags,get_metric_names,discover_metrics - Dashboards:
manage_dashboard,create_dashboard_visual,update_dashboard_visual
app_name e app_environment, comparados sem diferenciar maiúsculas de minúsculas. Se nenhuma aplicação corresponder, a ferramenta sugere os nomes mais próximos para que o agente possa tentar novamente.
Os campos de métrica também não diferenciam maiúsculas de minúsculas, então metric_type e field aceitam tanto P90 quanto p90.
Toda ferramenta também recebe uma string context, na qual o agente diz por que está fazendo a chamada. Os agentes geralmente a preenchem, então as tabelas a omitem.
manage_trigger, manage_log_line_action, manage_check_in_trigger e manage_uptime_monitor recebem um parâmetro action obrigatório que escolhe a operação. Nas tabelas delas, sim (upsert) marca um campo obrigatório em todo upsert. Sim (criação) marca um obrigatório apenas quando o upsert cria algo.
get_traces
Consulte traces de performance e erro, inspecione árvores de spans e visualize detalhes de spans.
Para adicionar uma nota a uma trace action de performance, use o manage_note.
Suporta dois tipos de trace:
- Performance traces — identificados por namespace e
action_name. Use-os para investigar requisições lentas. - Error traces — identificados por digest. Obtenha o digest a partir de
get_incidentouget_exception_incidents, depois use-o aqui para ver os traces de erro reais.
- Modo de lista — encontre traces e obtenha IDs de trace. Forneça namespace +
action_name, oudigest. Adicionetagspara manter apenas os traces com valores de tag correspondentes, como uma tag personalizadauser_id. - Modo de árvore — passe um
trace_idpara ver todos os spans como uma árvore compacta, junto com os metadados do span raiz e uma quebra de duração. A quebra reporta o self time por categoria: no que os spans de cada categoria gastaram tempo trabalhando, em vez de esperar por um filho. Um ID de trace funciona sozinho: você não precisa do namespace e do nome da action para consultar um. - Modo de detalhe de span — passe
trace_idespan_idpara atributos completos do span, eventos e informações de recurso. Valores de atributo longos são truncados em 500 caracteres. O texto de queries de banco de dados é a exceção, e vem por completo até 10.000 caracteres. Dados sensíveis que você solicitar cominclude_sensitivetambém vêm por completo, como variáveis do GraphQL nos parâmetros da requisição.
get_exception_incidents
Liste e pesquise exceções e erros do AppSignal.
Use isto para obter uma visão geral de exceções recentes, pesquisar em um período de tempo, encontrar incidentes por estado, ou verificar quais incidentes precisam de atenção. Retorna 50 incidentes por página.
Para prompts que pedem ao seu agente por novos erros, veja Verificando o que um deploy quebrou.
get_metrics_list
Obtenha um valor agregado para uma métrica em um intervalo de tempo.
Retorna um único valor agregado em vez de uma timeseries ponto a ponto. Útil para visões de resumo.
Contando linhas de log:
Passe
log_metrics como metric_name, com o tipo de métrica gauge, para contar linhas de log ou agregar um campo de log sem buscar as linhas. O AppSignal calcula o resultado a partir das suas linhas de log armazenadas e retorna uma linha por valor de group_by em todo o intervalo de tempo. Descreva a consulta em tags:
Esta requisição conta as linhas de log
signup em uma fonte, por severidade:
get_metrics_timeseries, que retorna um valor por intervalo de tempo. Cada consulta percorre suas linhas de log armazenadas, então, para uma contagem que você vai consultar com frequência, como em um dashboard ou em um gatilho, crie uma ação de log line de métricas.
get_metrics_timeseries
Obtenha uma timeseries para uma métrica na aplicação fornecida.
Retorna os valores de uma métrica ao longo de um intervalo de tempo, para um tipo de métrica e uma combinação de tags. Os valores de tag suportam correspondência por wildcard com *.
Em hosts que suportam a extensão MCP Apps, como Claude e ChatGPT, o resultado é renderizado como um gráfico interativo do AppSignal, construído a partir dos mesmos componentes dos seus dashboards. Em clientes somente texto, como Claude Code, Cursor e Codex, o assistente lê os valores e responde com suas próprias palavras.
O resultado contém:
- Um resumo: o intervalo de tempo e o intervalo entre valores e, para cada série, sua unidade, pico, mínimo, média e os períodos sem dados.
- Uma tabela CSV dos valores: uma linha por intervalo. Um intervalo sem dados é um campo vazio, nunca
0, para que não pareça uma queda para zero. O intervalo que ainda está em andamento é marcado comopartial. - Dados estruturados, para clientes que executam código. Um intervalo sem dados é
null.
resolution pede valores por minuto, hora ou dia. Valores por minuto só funcionam para um intervalo de 12 horas ou menos que comece nas últimas 48 horas. O resultado informa o intervalo usado.
Veja Verificando uma métrica ao longo do tempo para exemplos de prompts.
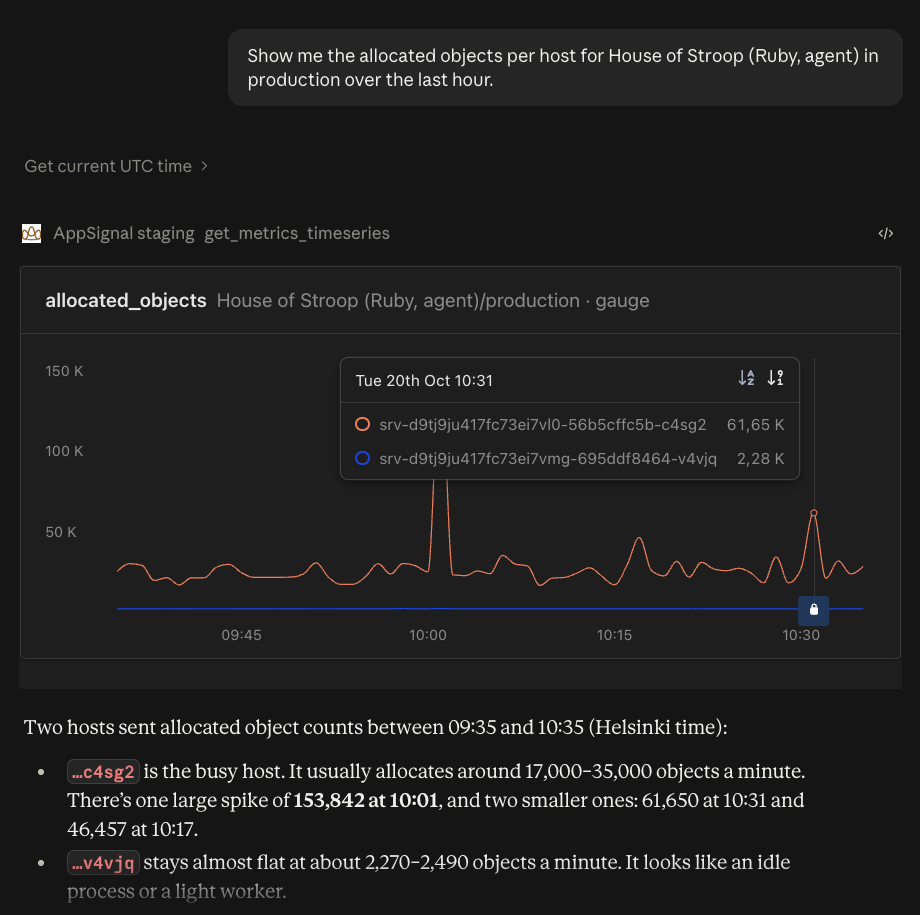
Uma chamada a get_metrics_timeseries sendo renderizada como um gráfico do AppSignal no Claude, seguida pelo resumo de Claude sobre os dados.
get_incident
Obtenha informações detalhadas sobre um incidente do AppSignal.
Retorna o estado atual, atribuição, primeira e última ocorrência, mensagens de erro, stack traces ou detalhes de alerta de anomalia. Suporta incidentes de exceção, anomalia e performance. Para um incidente de performance, também retorna a duração média e um detalhamento por deploy.
A resposta sempre lista as notas do incidente, com o ID de cada uma. Passe esse ID para manage_note para editar uma nota que você escreveu.
get_log_lines
Consulte linhas de log usando a sintaxe de expressão do AppSignal.
Suporta correspondência exata, contém, negação, comparações numéricas, lógica booleana e atributos aninhados. Retorna até 100 linhas por chamada, mais recentes primeiro por padrão. Para intervalos de tempo grandes, divida em várias chamadas e itere para frente.
Para contar linhas de log ou agregar um campo de log, use get_metrics_list com log_metrics.
Uma chamada pode cobrir, no máximo, a janela de consulta da sua conta, que depende do seu volume de logs. Um intervalo maior é cortado para caber nessa janela. Você recebe a parte mais recente por padrão, ou a mais antiga com order: asc. A resposta informa o que foi retornado e qual intervalo de tempo solicitar em seguida.
Na saída de texto, cada linha é encabeçada por uma prévia de 120 caracteres da mensagem. Uma mensagem mais longa recebe uma linha Message separada com o texto completo, limitado a 2.000 caracteres.
Sintaxe de consulta:
Campos disponíveis:
severity, hostname, group, message, e quaisquer atributos personalizados.
get_app_resources
Descubra os recursos disponíveis em uma aplicação do AppSignal — namespaces, dashboards, usuários, notificadores, fontes de log, log views, ações de log line, marcadores de deploy e uptime monitors.
Particularmente útil ao configurar gatilhos, atribuir incidentes ou entender a estrutura de uma aplicação.
A seção
deploy_markers retorna até 100 deploys recentes, cada um com sua revisão completa e o intervalo de tempo em que esteve ativo. Restrinja com deploy_marker_namespace ou deploy_marker_revision. Para encontrar os erros que um deploy introduziu, passe sua revisão para get_exception_incidents com new_only: true. Sem new_only, você recebe todo erro reportado nesse deploy, incluindo erros vistos pela primeira vez em um deploy anterior.
A seção uptime_monitors lista cada URL monitorada com seu ID, regiões, warm-up, verificação de corpo, notificadores e nomes dos headers de requisição. Os valores dos headers nunca são exibidos, pois podem conter credenciais. Para criar, alterar ou excluir um monitor, use manage_uptime_monitor. O uptime em si não é armazenado — ele é calculado a partir de métricas, então consulte o counter uptime_monitor_error_count com get_metrics_timeseries para calculá-lo. Para um detalhamento por fase, consulte uptime_monitor_timing com uma tag phase. Veja tempo de requisição.
get_applications
Obtenha todas as aplicações do AppSignal às quais o usuário tem acesso.
Retorna as aplicações no formato app_name/app_environment. Use isto quando precisar da lista completa. As outras ferramentas não precisam dela primeiro: quando um nome não corresponde, elas sugerem as aplicações mais parecidas.
Nenhum parâmetro específico da tarefa além de context.
get_anomaly_incidents
Liste e pesquise alertas de Anomaly detection do AppSignal.
Retorna 50 alertas por página, incluindo timestamps e valores para cada alerta.
get_performance
Visão geral de performance: traces de performance baseados em amostras e actions lentas a partir de traces.
Para apps padrão de Ruby e Elixir, retorna traces de performance baseados em amostras. Para apps que também enviam traces do OpenTelemetry, retorna adicionalmente uma lista ranqueada de actions com duração média, throughput e taxa de erro. Apps em migração para OpenTelemetry podem retornar ambos.
O throughput para actions do OpenTelemetry é uma média por minuto no intervalo de tempo solicitado. O número total de requisições nesse intervalo é exibido ao lado.
Ferramentas de acompanhamento: use get_incident para inspecionar um incidente de performance específico, get_traces para puxar traces para uma action lenta, e update_incidents para alterar estado, severidade ou responsáveis.
get_metric_tags
Obtenha as tags e o tipo de métrica (Gauge, Counter, etc.) para uma métrica específica.
Use os resultados para construir queries válidas com get_metrics_timeseries e get_metrics_list.
update_incidents
Atualize incidentes em massa para uma aplicação do AppSignal.
Use isto para alterar o estado do incidente, atualizar a severidade ou atribuir e desatribuir membros da equipe em vários incidentes de uma vez. Use get_app_resources com sections: ["users"] para encontrar IDs de usuários para atribuição.
get_metric_names
Obtenha os nomes de todas as métricas para a aplicação fornecida.
Retorna os nomes das métricas como uma string separada por vírgulas. Use-os como entrada para get_metric_tags, get_metrics_timeseries e get_metrics_list.
get_triggers
Liste gatilhos de Anomaly detection para uma aplicação do AppSignal.
Retorna gatilhos ativos (não arquivados) com sua configuração completa — condições, notificadores e links de dashboard. Use isto para encontrar IDs de gatilhos antes de chamar manage_trigger.
discover_metrics
Descubra categorias de métricas disponíveis e suas métricas para monitoramento.
Use isto para obter uma visão geral do que pode monitorar, ou para investigar uma categoria específica. Também aceita uma referência dashboard:<dashboard_id> para mostrar métricas usadas em um dashboard específico.
A categoria uptime_monitoring cobre verificações com falha, tempo de resposta, dias até a expiração do certificado SSL e uptime_monitor_timing, o tempo que cada etapa de uma verificação levou. Para todas as etapas de uma vez, consulte uptime_monitor_timing com get_metrics_timeseries e * como valor de phase. get_metrics_list não retorna nada para *, então passe uma única fase.
manage_trigger
Cria, atualiza ou arquiva um gatilho de Anomaly detection.
Os gatilhos são imutáveis. Quando você atualiza um gatilho, o AppSignal arquiva o existente, fechando todos os seus alertas e incidentes, e cria um substituto. Forneça todos os campos tanto para operações de criação quanto de atualização.
Use get_metric_names e get_metric_tags para descobrir métricas e campos disponíveis. Use get_app_resources(sections: ["notifiers"]) para encontrar IDs de notificadores.
Esta ferramenta substitui o antigo fluxo
archive_trigger. O nome antigo ainda funciona como um alias de compatibilidade retroativa, mas manage_trigger é a ferramenta principal.get_check_in_triggers
Lista monitors de check-in (cron e heartbeat), ou inspeciona um monitor com suas execuções recentes.
As duas ferramentas de check-in cobrem os mesmos monitors que o process monitoring: monitors cron, que esperam uma execução em um agendamento, e monitors heartbeat, que esperam um sinal contínuo.
Use isto para ver quais jobs ou serviços agendados devem reportar, verificar se estão no prazo, ou encontrar o ID de um monitor antes de atualizá-lo.
manage_check_in_trigger
Cria, atualiza ou exclui um monitor de check-in.
Diferente dos gatilhos de Anomaly detection, os monitors de check-in são atualizados no lugar. Quando você atualiza um, os campos omitidos mantêm seus valores atuais.
manage_uptime_monitor
Cria, atualiza ou exclui um uptime monitor. Para listar monitors com suas configurações, use get_app_resources com a seção uptime_monitors.
Um uptime monitor é uma URL que o AppSignal verifica a cada minuto a partir de uma ou mais regiões. O AppSignal alerta você quando a URL não pode ser alcançada.
Atualizações alteram o monitor no lugar: os campos omitidos mantêm seus valores atuais. regions, notifier_ids e headers substituem a lista atual em vez de adicionar a ela.
Para prompts que configuram e consultam um monitor, veja Configurando um uptime monitor.
manage_log_line_action
Cria, atualiza, reordena ou exclui uma ação de log line.
As ações de log line são executadas durante a ingestão de logs, na ordem que você definir. Existem três tipos:
- filter — descarta as linhas de log correspondentes para que nunca sejam armazenadas ou processadas posteriormente
- trigger — dispara alertas e incidentes quando a query corresponde
- metrics — extrai métricas de counter, gauge ou distribution das linhas de log correspondentes
Esta ferramenta substitui os antigos fluxos
reorder_log_line_actions e delete_log_line_action. Esses nomes ainda funcionam como aliases de compatibilidade retroativa, mas manage_log_line_action é a ferramenta principal.manage_note
Crie ou atualize uma nota em um incidente do AppSignal ou em uma trace action de performance. Markdown é suportado.
Use isto para adicionar comentários, atualizações de status, descobertas de investigação ou passos de resolução. Identifique o alvo com number para um incidente, ou com namespace e action_name para uma trace action de performance. Informar os dois retorna um erro.
Uma nota em uma trace action de performance é compartilhada por todos os traces dessa action. Ela permanece depois que os dados de trace da action expiram. Uma nota em um incidente de performance é armazenada na trace action do incidente, não no incidente. Ela permanece disponível depois que o incidente é fechado. Veja a documentação da página de traces para saber onde essas notas aparecem.
Mencione uma issue ou um pull request do GitHub em uma nota de incidente para vinculá-lo: sua URL, ou a forma abreviada owner/repo#123. Isso requer que o app tenha o GitHub configurado. A referência deve apontar para um repositório da mesma organização do GitHub. A vinculação ao GitHub não se aplica a notas em trace actions.
Uma nota de incidente também vincula issues do Linear, Jira e GitLab, mas apenas pela URL completa, como https://linear.app/acme/issue/ENG-42. Formas abreviadas não funcionam para eles. Você precisa ter configurado a integração desse tracker para o app por conta própria, porque o AppSignal busca a issue com a sua conta. Veja Linear, Jira e GitLab para saber o que é vinculado.
Esta ferramenta era anteriormente chamada de
manage_incident_note, e antes disso de create_incident_note. Ambos os nomes antigos ainda funcionam como aliases, então prompts e configurações existentes continuam funcionando.manage_dashboard
Crie ou atualize um dashboard do AppSignal.
Esta ferramenta gerencia apenas os metadados do dashboard (título e descrição). Use create_dashboard_visual e update_dashboard_visual para adicionar gráficos.
O MCP adiciona e atualiza, mas não remove. Para excluir um gráfico ou um dashboard inteiro, abra os dashboards da sua aplicação no AppSignal.
create_dashboard_visual
Adicione um novo gráfico a um dashboard existente. Há dois tipos de visual disponíveis:
timeseries(padrão) — um gráfico de linha ou área que plota uma ou mais métricas ao longo do tempo.number— um tile Big Number mostrando uma única métrica agregada, útil para um total, a leitura mais recente ou uma média rápida.
discover_metrics ou get_metrics_list para encontrar métricas disponíveis primeiro.
Estes parâmetros se aplicam a ambos os tipos de visual:
Estes parâmetros se aplicam apenas a visuais
timeseries:
Estes parâmetros se aplicam apenas a visuais
number:
Um tile Big Number recebe uma métrica e uma agregação no intervalo de tempo selecionado do dashboard. O nome da métrica e as tags dele não podem conter um wildcard (
*), porque o tile mostra uma única série. Peça isso em linguagem natural:
Text
create_dashboard_visual:
update_dashboard_visual
Atualize um gráfico existente em um dashboard. Isso funciona tanto para visuais timeseries quanto Big Number — o tipo é lido a partir do visual existente, então você não passa type.
Todos os campos são opcionais, exceto os identificadores, e os campos não especificados mantêm seus valores atuais. Passar metrics ou metric substitui toda a definição de métrica naquele visual, em vez de mesclar com ela.
Saída estruturada
Seis ferramentas retornam dados estruturados junto com a saída de texto. Cada uma declara um output schema, para que clientes MCP que executam código possam ler campos tipados em vez de analisar o texto. A saída de texto continua sendo retornada, então agentes que a leem funcionam da mesma forma.app é a aplicação no formato app_name/app_environment, por exemplo Shop/production.
Em get_log_lines, cada linha tem id, timestamp, severity, group, hostname, source_id, message e attributes. message contém a mensagem completa, limitada a 2.000 caracteres. attributes contém os atributos JSON da linha como um objeto, ou null quando eles não formam um objeto JSON. full_page é true quando a chamada retornou tantas linhas quanto o seu limite. continuation contém o start e o end a solicitar em seguida quando o intervalo foi cortado para caber na sua janela de consulta. Caso contrário, é null. url aponta para a mesma busca na página Logs.
Ferramentas de leitura e escrita
Toda ferramenta ou apenas lê seus dados ou pode alterá-los, e o nome dela indica qual: as ferramentasget_ e discover_ só leem, enquanto as ferramentas create_, update_ e manage_ escrevem. A exclusão fica dentro das ferramentas manage_, em vez de ter ferramentas próprias: manage_log_line_action remove uma ação, manage_check_in_trigger e manage_uptime_monitor removem um monitor, e manage_trigger arquiva um. É por essa divisão que os clientes MCP agrupam as ferramentas, para que você possa configurar no seu agente quais ferramentas permitir, quais aprovar caso a caso, e quais bloquear.
Permissões de token
Cada token MCP é limitado às aplicações que você seleciona, ou a todas as aplicações, incluindo as criadas depois, e às ferramentas que você expõe nesse token. Se você quiser uma configuração mais restrita para um agente, é aqui que você a limita. Por exemplo, você pode expor apenasget_applications, get_app_resources e get_exception_incidents para um agente de triagem de incidentes, ou get_log_lines e manage_log_line_action para trabalho de ingestão de logs.
Você também pode configurar um token para expor automaticamente novas ferramentas conforme elas forem adicionadas depois. Para os passos de como criar um, veja Autenticação.
Faltando uma ferramenta?
Além das ferramentas acima, o AppSignal MCP expõe oget_more_tools, uma ferramenta de descoberta e feedback. Ela cumpre duas funções:
- Registrar um pedido de uma capacidade que você não conseguiu encontrar
- Enviar feedback sobre como uma tarefa ou chamada de ferramenta se saiu
get_more_tools recebe estes parâmetros:
A maioria dos agentes não vai usá-la por conta própria, então peça explicitamente:
“Use a tool
get_more_tools do AppSignal para pedir uma forma de exportar incidentes em massa para CSV.”
Ou, quando uma tarefa funcionou parcialmente:
“Use a tool get_more_tools do AppSignal para enviar feedback de que get_log_lines encontrou os logs certos, mas eu ainda precisei de um segundo passo para resumi-los.”