
get_more_tools, mit dem Sie nach neuen Fähigkeiten fragen und Feedback geben können. Sie rufen die Tools nicht selbst auf. Nachdem Sie AppSignal MCP eingerichtet haben, fragen Sie Ihren Agenten, zum Beispiel: „Welche Aktionen sind gerade in der Produktion am langsamsten?” Der Agent wählt das Tool aus und füllt die Parameter aus. Prüfen Sie hier, ob eine Fähigkeit existiert oder welchen Parameter Sie nennen sollten, wenn Ihr Agent einen falsch wählt.
Beispiel-Prompts, die mehrere Tools kombinieren, finden Sie unter AppSignal MCP-Workflows.
Tool-Referenz
Die Tools sind nach Nutzungshäufigkeit sortiert, die meistgenutzten zuerst:
Nach Produktbereich:
- App-Discovery:
get_app_resources,get_applications - Fehlervorfälle:
get_exception_incidents,get_incident,update_incidents,manage_note - Performance:
get_traces,get_performance - Anomaly detection:
get_anomaly_incidents,get_triggers,manage_trigger - Check-ins:
get_check_in_triggers,manage_check_in_trigger - Uptime monitoring:
manage_uptime_monitor - Logging:
get_log_lines,manage_log_line_action - Metriken:
get_metrics_list,get_metrics_timeseries,get_metric_tags,get_metric_names,discover_metrics - Dashboards:
manage_dashboard,create_dashboard_visual,update_dashboard_visual
app_name und app_environment, die ohne Berücksichtigung der Groß-/Kleinschreibung abgeglichen werden. Wenn keine Anwendung übereinstimmt, schlägt das Tool die naheliegendsten Namen vor, sodass der Agent es erneut versuchen kann.
Auch Metrikfelder berücksichtigen keine Groß-/Kleinschreibung, daher akzeptieren metric_type und field sowohl P90 als auch p90.
Jedes Tool nimmt außerdem eine context-Zeichenkette entgegen, in der der Agent angibt, warum er den Aufruf tätigt. Agenten füllen sie normalerweise aus, daher lassen die Tabellen sie weg.
manage_trigger, manage_log_line_action, manage_check_in_trigger und manage_uptime_monitor benötigen einen action-Parameter, der die Operation auswählt. In ihren Tabellen kennzeichnet ja (upsert) ein Feld, das bei jedem Upsert erforderlich ist. Ja (Erstellung) kennzeichnet eines, das nur erforderlich ist, wenn der Upsert etwas erstellt.
get_traces
Performance- und Fehler-Traces abfragen, Span-Bäume untersuchen und Span-Details anzeigen.
Um einer Performance-Trace-Aktion eine Notiz hinzuzufügen, verwenden Sie manage_note.
Unterstützt zwei Trace-Typen:
- Performance traces — identifiziert durch Namespace und
action_name. Verwenden Sie diese, um langsame Anfragen zu untersuchen. - Error traces — identifiziert durch Digest. Holen Sie sich den Digest aus
get_incidentoderget_exception_incidents, und verwenden Sie ihn dann hier, um die tatsächlichen Fehler-Traces zu sehen.
- Listenmodus — Traces finden und Trace-IDs abrufen. Geben Sie Namespace +
action_nameoderdigestan. Fügen Sietagshinzu, um nur die Traces mit übereinstimmenden Tag-Werten zu behalten, etwa einem benutzerdefiniertenuser_id-Tag. - Baummodus — Übergeben Sie eine
trace_id, um alle Spans als kompakten Baum anzuzeigen, zusammen mit den Metadaten des Root-Spans und einer Aufschlüsselung der Dauer. Die Aufschlüsselung zeigt die Eigenzeit nach Kategorie: womit die Spans in jeder Kategorie tatsächlich beschäftigt waren, statt auf ein Child zu warten. Eine Trace-ID funktioniert für sich allein: Sie benötigen nicht den Namespace und den Aktionsnamen, um eine nachzuschlagen. - Span-Detailmodus — Übergeben Sie
trace_idundspan_idfür vollständige Span-Attribute, -Ereignisse und -Ressourceninformationen. Lange Attributwerte werden bei 500 Zeichen abgeschnitten. Eine Ausnahme bildet der Text von Datenbankabfragen, der bis zu 10.000 Zeichen vollständig durchkommt. Sensible Daten, die Sie mitinclude_sensitiveanfordern, kommen ebenfalls vollständig durch, etwa GraphQL-Variablen in den Request-Parametern.
get_exception_incidents
Listet AppSignal-Ausnahmen und -Fehler auf und durchsucht sie.
Verwenden Sie dies, um einen Überblick über aktuelle Ausnahmen zu erhalten, innerhalb eines Zeitraums zu suchen, Vorfälle nach Zustand zu finden oder zu prüfen, welche Vorfälle Aufmerksamkeit benötigen. Gibt 50 Vorfälle pro Seite zurück.
Für Prompts, die Ihren Agenten nach neuen Fehlern fragen, siehe Prüfen, was ein Deploy kaputt gemacht hat.
get_metrics_list
Ruft einen aggregierten Wert für eine Metrik über einen Zeitbereich ab.
Gibt einen einzelnen aggregierten Wert anstelle einer Punkt-für-Punkt-Zeitreihe zurück. Nützlich für Übersichtsansichten.
Zählen von Protokollzeilen:
Übergeben Sie
log_metrics als metric_name mit dem Metriktyp gauge, um Protokollzeilen zu zählen oder ein Protokollfeld zu aggregieren, ohne die Zeilen abzurufen. AppSignal berechnet das Ergebnis aus Ihren gespeicherten Protokollzeilen und gibt eine Zeile pro group_by-Wert über den gesamten Zeitbereich zurück. Beschreiben Sie die Abfrage in tags:
Diese Anfrage zählt die
signup-Protokollzeilen in einer Quelle, pro Severity:
get_metrics_timeseries, das einen Wert pro Zeitintervall zurückgibt. Jede Abfrage durchsucht Ihre gespeicherten Protokollzeilen. Für eine Zählung, die Sie häufig abfragen, etwa in einem Dashboard oder einem Trigger, erstellen Sie daher stattdessen eine Metrik-Protokollzeilen-Aktion.
get_metrics_timeseries
Ruft eine Zeitreihe für eine Metrik in der angegebenen Anwendung ab.
Gibt die Werte einer Metrik über einen Zeitbereich zurück, für einen Metriktyp und eine Tag-Kombination. Tag-Werte unterstützen Platzhalterabgleich mit *.
In Hosts, die die MCP-Apps-Erweiterung unterstützen, wie Claude und ChatGPT, wird das Ergebnis als interaktives AppSignal-Diagramm dargestellt, das aus denselben Komponenten wie Ihre Dashboards aufgebaut ist. In reinen Text-Clients, wie Claude Code, Cursor und Codex, liest der Assistent die Werte und antwortet in eigenen Worten.
Das Ergebnis enthält:
- Eine Zusammenfassung: den Zeitbereich und das Intervall sowie für jede Serie ihre Einheit, den Höchstwert, den Tiefstwert, den Durchschnitt und die Zeiträume ohne Daten.
- Eine CSV-Tabelle der Werte: eine Zeile pro Intervall. Ein Intervall ohne Daten ist ein leeres Feld, nie
0, damit es nicht wie ein Abfall auf null aussieht. Das noch laufende Intervall ist alspartialmarkiert. - Strukturierte Daten für Clients, die Code ausführen. Ein Intervall ohne Daten ist
null.
resolution fordert Werte pro Minute, Stunde oder Tag an. Werte pro Minute funktionieren nur für einen Zeitbereich von höchstens 12 Stunden, der innerhalb der letzten 48 Stunden beginnt. Das Ergebnis gibt das verwendete Intervall an.
Beispiel-Prompts finden Sie unter Eine Metrik über die Zeit prüfen.
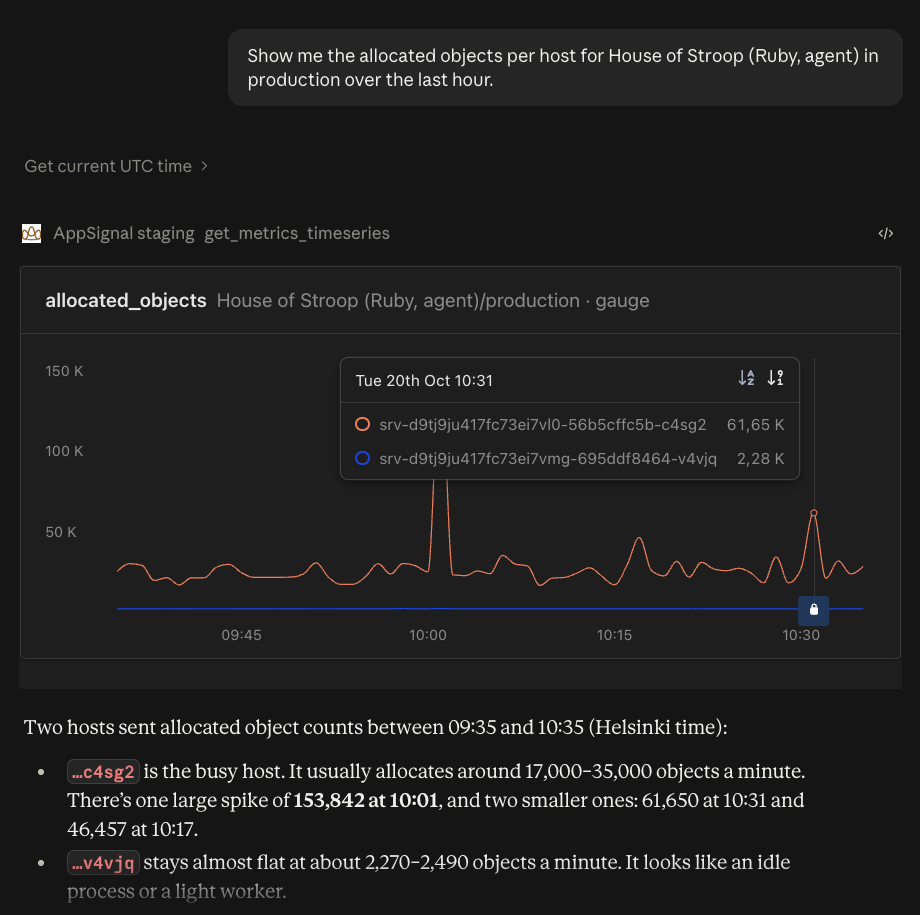
Ein get_metrics_timeseries-Aufruf, der in Claude als AppSignal-Diagramm dargestellt wird, gefolgt von Claudes Zusammenfassung der Daten.
get_incident
Ruft detaillierte Informationen über einen AppSignal-Vorfall ab.
Gibt den aktuellen Zustand, die Zuweisung, das erste und letzte Auftreten, Fehlermeldungen, Stack-Traces oder Details zur Anomaliebenachrichtigung zurück. Unterstützt Ausnahme-, Anomalie- und Performance-Vorfälle. Für einen Performance-Vorfall gibt es außerdem die mittlere Dauer und eine Aufschlüsselung nach Deploy zurück.
Die Antwort listet immer die Notizen des Vorfalls auf, jeweils mit ihrer ID. Übergeben Sie diese ID an manage_note, um eine von Ihnen verfasste Notiz zu bearbeiten.
get_log_lines
Fragt Protokollzeilen mit der Ausdruckssyntax von AppSignal ab.
Unterstützt exakte Übereinstimmung, enthält, Negation, numerische Vergleiche, Boolean-Logik und verschachtelte Attribute. Gibt bis zu 100 Zeilen pro Aufruf zurück, standardmäßig neueste zuerst. Bei großen Zeitbereichen in mehrere Aufrufe aufteilen und vorwärts iterieren.
Um Protokollzeilen zu zählen oder ein Protokollfeld zu aggregieren, verwenden Sie stattdessen get_metrics_list mit log_metrics.
Ein Aufruf kann höchstens das Abfragefenster Ihres Accounts abdecken, das von Ihrem Protokollvolumen abhängt. Ein längerer Zeitbereich wird auf dieses Fenster zugeschnitten. Standardmäßig erhalten Sie den neuesten Teil, oder mit order: asc den ältesten. Die Antwort gibt an, was zurückgegeben wurde und welcher Zeitbereich als Nächstes angefragt werden sollte.
In der Textausgabe beginnt jede Zeile mit einer 120 Zeichen langen Vorschau ihrer Nachricht. Eine längere Nachricht erhält eine separate Message-Zeile mit dem vollständigen Text, begrenzt auf 2.000 Zeichen.
Abfragesyntax:
Verfügbare Felder:
severity, hostname, group, message und beliebige benutzerdefinierte Attribute.
get_app_resources
Entdeckt verfügbare Ressourcen in einer AppSignal-Anwendung — Namespaces, Dashboards, Benutzer, Notifier, Protokollquellen, Log Views, Protokollzeilen-Aktionen, Deploy Markers und Uptime-Monitore.
Besonders nützlich beim Einrichten von Triggern, Zuweisen von Vorfällen oder beim Verständnis der Struktur einer Anwendung.
Die Sektion
deploy_markers gibt bis zu 100 aktuelle Deploys zurück, jeweils mit ihrer vollständigen Revision und dem Zeitraum, in dem sie aktiv waren. Grenzen Sie sie mit deploy_marker_namespace oder deploy_marker_revision ein. Um die Fehler zu finden, die ein Deploy verursacht hat, übergeben Sie dessen Revision an get_exception_incidents mit new_only: true. Ohne new_only erhalten Sie jeden Fehler, der in diesem Deploy gemeldet wurde. Das schließt Fehler ein, die erstmals in einem früheren Deploy aufgetreten sind.
Die Sektion uptime_monitors listet jede überwachte URL mit ihrer ID, den Regionen, Warm-up, Body-Prüfung, Notifiern und Request-Header-Namen auf. Header-Werte werden nie angezeigt, da sie Zugangsdaten enthalten können. Um einen Monitor zu erstellen, zu ändern oder zu löschen, verwenden Sie manage_uptime_monitor. Die Uptime selbst wird nicht gespeichert — sie wird aus Metriken berechnet. Fragen Sie also den Counter uptime_monitor_error_count mit get_metrics_timeseries ab, um sie zu berechnen. Für eine Aufschlüsselung nach Phasen fragen Sie uptime_monitor_timing mit einem phase-Tag ab. Siehe Request-Timing.
get_applications
Ruft alle AppSignal-Anwendungen ab, auf die der Benutzer Zugriff hat.
Gibt Anwendungen im Format app_name/app_environment zurück. Verwenden Sie dies, wenn Sie die vollständige Liste benötigen. Andere Tools benötigen es nicht zuerst: Wenn ein Name nicht übereinstimmt, schlagen sie die naheliegendsten passenden Anwendungen vor.
Keine aufgabenspezifischen Parameter außer context.
get_anomaly_incidents
Listet AppSignal-Anomaly detections-Alerts auf und durchsucht sie.
Gibt 50 Alerts pro Seite zurück, einschließlich Zeitstempel und Werten für jeden Alert.
get_performance
Performance-Überblick: Sample-basierte Performance-Traces und langsame Aktionen aus Traces.
Für Standard-Ruby- und Elixir-Apps gibt sample-basierte Performance-Traces zurück. Für Apps, die auch OpenTelemetry-Traces senden, gibt zusätzlich eine sortierte Liste von Aktionen mit mittlerer Dauer, Durchsatz und Fehlerquote zurück. Apps, die zu OpenTelemetry migriert werden, können beides zurückgeben.
Der Durchsatz für OpenTelemetry-Aktionen ist ein Durchschnitt pro Minute über den angefragten Zeitbereich. Die Gesamtzahl der Requests in diesem Zeitbereich wird daneben angezeigt.
Folge-Tools: Verwenden Sie get_incident, um einen bestimmten Performance-Vorfall zu untersuchen, get_traces, um Traces für eine langsame Aktion abzurufen, und update_incidents, um Zustand, Schweregradstufe oder Zuständige zu ändern.
get_metric_tags
Ruft die Tags und den Metriktyp (Gauge, Counter usw.) für eine bestimmte Metrik ab.
Verwenden Sie die Ergebnisse, um gültige Abfragen mit get_metrics_timeseries und get_metrics_list zu erstellen.
update_incidents
Aktualisiert Vorfälle für eine AppSignal-Anwendung in einem Batch.
Verwenden Sie dies, um den Vorfallzustand zu ändern, die Schweregradstufe zu aktualisieren oder Teammitglieder bei mehreren Vorfällen gleichzeitig zuzuweisen oder zu entfernen. Verwenden Sie get_app_resources mit sections: ["users"], um Benutzer-IDs für die Zuweisung zu finden.
get_metric_names
Ruft die Namen aller Metriken für die angegebene Anwendung ab.
Gibt Metriknamen als komma-separierte Zeichenkette zurück. Verwenden Sie diese als Eingabe für get_metric_tags, get_metrics_timeseries und get_metrics_list.
get_triggers
Listet die Anomaly detections-Trigger für eine AppSignal-Anwendung auf.
Gibt aktive (nicht archivierte) Trigger mit ihrer vollständigen Konfiguration zurück — Bedingungen, Notifier und Dashboard-Links. Verwenden Sie dies, um Trigger-IDs zu finden, bevor Sie manage_trigger aufrufen.
discover_metrics
Entdeckt verfügbare Metrikkategorien und ihre Metriken für die Überwachung.
Verwenden Sie dies, um einen Überblick darüber zu erhalten, was Sie überwachen können, oder um in eine bestimmte Kategorie einzutauchen. Akzeptiert auch eine dashboard:<dashboard_id>-Referenz, um Metriken anzuzeigen, die in einem bestimmten Dashboard verwendet werden.
Die Kategorie uptime_monitoring umfasst fehlgeschlagene Prüfungen, die Antwortzeit, die Tage bis zum Ablauf des SSL-Zertifikats und uptime_monitor_timing, die Dauer jedes Schritts einer Prüfung. Um alle Schritte auf einmal abzurufen, fragen Sie uptime_monitor_timing mit get_metrics_timeseries und * als phase-Wert ab. get_metrics_list gibt für * nichts zurück, übergeben Sie dort also eine einzelne Phase.
manage_trigger
Erstellt, aktualisiert oder archiviert einen Anomaly detections-Trigger.
Trigger sind unveränderlich. Wenn Sie einen Trigger aktualisieren, archiviert AppSignal den vorhandenen, schließt all seine Alerts und Vorfälle und erstellt einen Ersatz. Geben Sie alle Felder sowohl für Erstellungs- als auch für Aktualisierungsvorgänge an.
Verwenden Sie get_metric_names und get_metric_tags, um verfügbare Metriken und Felder zu entdecken. Verwenden Sie get_app_resources(sections: ["notifiers"]), um Notifier-IDs zu finden.
Dieses Tool ersetzt den älteren
archive_trigger-Ablauf. Der alte Name funktioniert weiterhin als Alias zur Abwärtskompatibilität, aber manage_trigger ist das primäre Tool.get_check_in_triggers
Listet Check-in-Monitore (Cron und Heartbeat) auf oder untersucht einen Monitor mit seinen letzten Ausführungen.
Beide Check-in-Tools decken dieselben Monitore ab wie Process monitoring: Cron-Monitore, die eine Ausführung nach Zeitplan erwarten, und Heartbeat-Monitore, die ein kontinuierliches Signal erwarten.
Verwenden Sie dies, um zu sehen, welche geplanten Jobs oder Dienste sich melden sollen, zu prüfen, ob sie pünktlich sind, oder eine Monitor-ID zu finden, bevor Sie sie aktualisieren.
manage_check_in_trigger
Erstellt, aktualisiert oder löscht einen Check-in-Monitor.
Anders als Anomaly detections-Trigger werden Check-in-Monitore direkt aktualisiert. Wenn Sie einen aktualisieren, behalten ausgelassene Felder ihre aktuellen Werte.
manage_uptime_monitor
Erstellt, aktualisiert oder löscht einen Uptime-Monitor. Um Monitore und ihre Einstellungen aufzulisten, verwenden Sie get_app_resources mit der Sektion uptime_monitors.
Ein Uptime-Monitor ist eine URL, die AppSignal jede Minute von einer oder mehreren Regionen aus prüft. AppSignal benachrichtigt Sie, wenn die URL nicht erreichbar ist.
Aktualisierungen ändern den Monitor direkt: Ausgelassene Felder behalten ihre aktuellen Werte. regions, notifier_ids und headers ersetzen die aktuelle Liste, statt sie zu ergänzen.
Für Prompts, die einen Monitor einrichten und abfragen, siehe Einrichten eines Uptime-Monitors.
manage_log_line_action
Erstellt, aktualisiert, ordnet neu an oder löscht eine Protokollzeilen-Aktion.
Protokollzeilen-Aktionen werden während der Protokollerfassung in der von Ihnen definierten Reihenfolge ausgeführt. Es gibt drei Typen:
- filter — verwirft übereinstimmende Protokollzeilen, sodass sie nie gespeichert oder weiterverarbeitet werden
- trigger — löst Alerts und Vorfälle aus, wenn die Abfrage übereinstimmt
- metrics — extrahiert Counter-, Gauge- oder Distribution-Metriken aus übereinstimmenden Protokollzeilen
Dieses Tool ersetzt die älteren Abläufe
reorder_log_line_actions und delete_log_line_action. Diese Namen funktionieren weiterhin als Aliase zur Abwärtskompatibilität, aber manage_log_line_action ist das primäre Tool.manage_note
Erstellt oder aktualisiert eine Notiz zu einem AppSignal-Vorfall oder zu einer Performance-Trace-Aktion. Markdown wird unterstützt.
Verwenden Sie dies, um Kommentare, Statusaktualisierungen, Untersuchungsergebnisse oder Lösungsschritte hinzuzufügen. Identifizieren Sie das Ziel mit number für einen Vorfall, oder mit namespace und action_name für eine Performance-Trace-Aktion. Werden beide angegeben, gibt es einen Fehler.
Eine Notiz zu einer Performance-Trace-Aktion wird von jedem Trace dieser Aktion gemeinsam genutzt. Sie bleibt bestehen, nachdem die Trace-Daten der Aktion abgelaufen sind. Eine Notiz zu einem Performance-Vorfall wird bei der Trace-Aktion des Vorfalls gespeichert, nicht beim Vorfall selbst. Sie bleibt verfügbar, nachdem der Vorfall geschlossen wurde. Wo diese Notizen erscheinen, erfahren Sie in der Dokumentation zur Trace-Seite.
Erwähnen Sie ein GitHub-Issue oder einen Pull Request in einer Vorfall-Notiz, um die Verknüpfung herzustellen: über die URL oder die Kurzform owner/repo#123. Dies erfordert, dass die App mit GitHub konfiguriert ist. Der Verweis muss auf ein Repository derselben GitHub-Organisation zeigen. Die GitHub-Verknüpfung gilt nicht für Notizen zu Trace-Aktionen.
Eine Vorfall-Notiz verknüpft auch Linear-, Jira- und GitLab-Issues, allerdings nur über ihre vollständige URL, etwa https://linear.app/acme/issue/ENG-42. Kurzformen funktionieren für sie nicht. Sie müssen die Integration des jeweiligen Trackers selbst für die App eingerichtet haben, da AppSignal das Issue mit Ihrem Account sucht. Was verknüpft wird, erfahren Sie unter Linear, Jira und GitLab.
Dieses Tool hieß zuvor
manage_incident_note, und davor create_incident_note. Beide alten Namen funktionieren weiterhin als Aliase, sodass bestehende Prompts und Konfigurationen weiter funktionieren.manage_dashboard
Erstellt oder aktualisiert ein AppSignal-Dashboard.
Dieses Tool verwaltet nur Dashboard-Metadaten (Titel und Beschreibung). Verwenden Sie create_dashboard_visual und update_dashboard_visual, um Diagramme hinzuzufügen.
MCP fügt hinzu und aktualisiert, entfernt aber nichts. Um ein Diagramm oder ein ganzes Dashboard zu löschen, öffnen Sie die Dashboards Ihrer App in AppSignal.
create_dashboard_visual
Fügt einem vorhandenen Dashboard ein neues Diagramm hinzu. Es stehen zwei Visual-Typen zur Verfügung:
timeseries(Standard) — ein Linien- oder Flächendiagramm, das eine oder mehrere Metriken über die Zeit darstellt.number— eine Big-Number-Kachel, die eine einzelne aggregierte Metrik zeigt, nützlich für eine Summe, den letzten Messwert oder einen Durchschnitt auf einen Blick.
discover_metrics oder get_metrics_list, um verfügbare Metriken zu finden.
Diese Parameter gelten für beide Visual-Typen:
Diese Parameter gelten nur für
timeseries-Visuals:
Diese Parameter gelten nur für
number-Visuals:
Eine Big-Number-Kachel nimmt eine Metrik und eine Aggregation über den ausgewählten Zeitbereich des Dashboards. Ihr Metrikname und ihre Tags dürfen keinen Platzhalter (
*) enthalten, da die Kachel eine einzelne Serie zeigt. Fragen Sie in natürlicher Sprache danach:
Text
create_dashboard_visual-Aufruf:
update_dashboard_visual
Aktualisiert ein vorhandenes Diagramm in einem Dashboard. Dies funktioniert sowohl für Timeseries- als auch für Big-Number-Visuals — der Typ wird aus dem vorhandenen Visual gelesen, sodass Sie type nicht übergeben müssen.
Alle Felder sind optional außer den Identifikatoren, und nicht angegebene Felder behalten ihre aktuellen Werte. Wenn Sie metrics oder metric übergeben, wird die gesamte Metrikdefinition dieses Visuals ersetzt, statt hineinzumischen.
Strukturierte Ausgabe
Sechs Tools geben zusätzlich zu ihrer Textausgabe strukturierte Daten zurück. Jedes deklariert ein Ausgabeschema, sodass MCP-Clients, die Code ausführen, typisierte Felder lesen können, anstatt den Text zu parsen. Die Textausgabe wird weiterhin zurückgegeben, sodass Agenten, die sie lesen, genauso funktionieren wie bisher.app ist die Anwendung im Format app_name/app_environment, zum Beispiel Shop/production.
In get_log_lines hat jede Zeile id, timestamp, severity, group, hostname, source_id, message und attributes. message enthält die vollständige Nachricht, begrenzt auf 2.000 Zeichen. attributes enthält die JSON-Attribute der Zeile als Objekt oder null, wenn sie kein JSON-Objekt sind. full_page ist true, wenn der Aufruf so viele Zeilen zurückgegeben hat, wie sein Limit erlaubt. continuation enthält start und end für die nächste Anfrage, wenn der Zeitbereich auf Ihr Abfragefenster gekürzt wurde. Andernfalls ist es null. url verlinkt auf dieselbe Suche auf der Logs-Seite.
Lese- und Schreib-Tools
Jedes Tool liest entweder nur Ihre Daten oder kann sie ändern, und sein Name verrät, welches:get_- und discover_-Tools lesen nur, während create_-, update_- und manage_-Tools schreiben. Löschen ist Teil der manage_-Tools und hat kein eigenes Tool: manage_log_line_action entfernt eine Aktion, manage_check_in_trigger und manage_uptime_monitor entfernen einen Monitor, und manage_trigger archiviert einen. Nach genau dieser Aufteilung gruppieren MCP-Clients, sodass Sie in Ihrem Agenten festlegen können, welche Tools erlaubt sind, welche Sie im Einzelfall genehmigen und welche Sie blockieren.
Token-Berechtigungen
Jedes MCP-Token ist auf die von Ihnen ausgewählten Anwendungen oder auf alle Anwendungen, einschließlich später erstellter, sowie auf die Tools beschränkt, die Sie für dieses Token freigeben. Wenn Sie eine engere Einrichtung für einen Agenten möchten, schränken Sie sie hier ein. Zum Beispiel könnten Sie für einen Agenten zur Vorfall-Triage nurget_applications, get_app_resources und get_exception_incidents freigeben, oder get_log_lines und manage_log_line_action für Arbeiten an der Protokollerfassung.
Sie können ein Token auch so einstellen, dass neue Tools automatisch freigegeben werden, sobald sie später hinzugefügt werden. Die Schritte zum Erstellen finden Sie unter Authentifizierung.
Fehlt ein Tool?
Neben den oben genannten Tools stellt AppSignal MCPget_more_tools bereit, ein Tool für Discovery und Feedback. Es erledigt zwei Aufgaben:
- Protokolliert eine Anfrage für eine Fähigkeit, die Sie nicht finden konnten
- Erfasst Feedback dazu, wie eine Aufgabe oder ein Tool-Aufruf verlaufen ist
get_more_tools nimmt diese Parameter entgegen:
Die meisten Agenten greifen von sich aus nicht danach, also fragen Sie explizit:
„Verwende das AppSignal-Tool
get_more_tools, um nach einer Möglichkeit zu fragen, Vorfälle im Batch als CSV zu exportieren.”
Oder, wenn eine Aufgabe teilweise funktioniert hat:
„Verwende das AppSignal-Tool get_more_tools, um Feedback einzureichen, dass get_log_lines die richtigen Protokolle gefunden hat, ich aber noch einen zweiten Schritt brauchte, um sie zusammenzufassen.”