
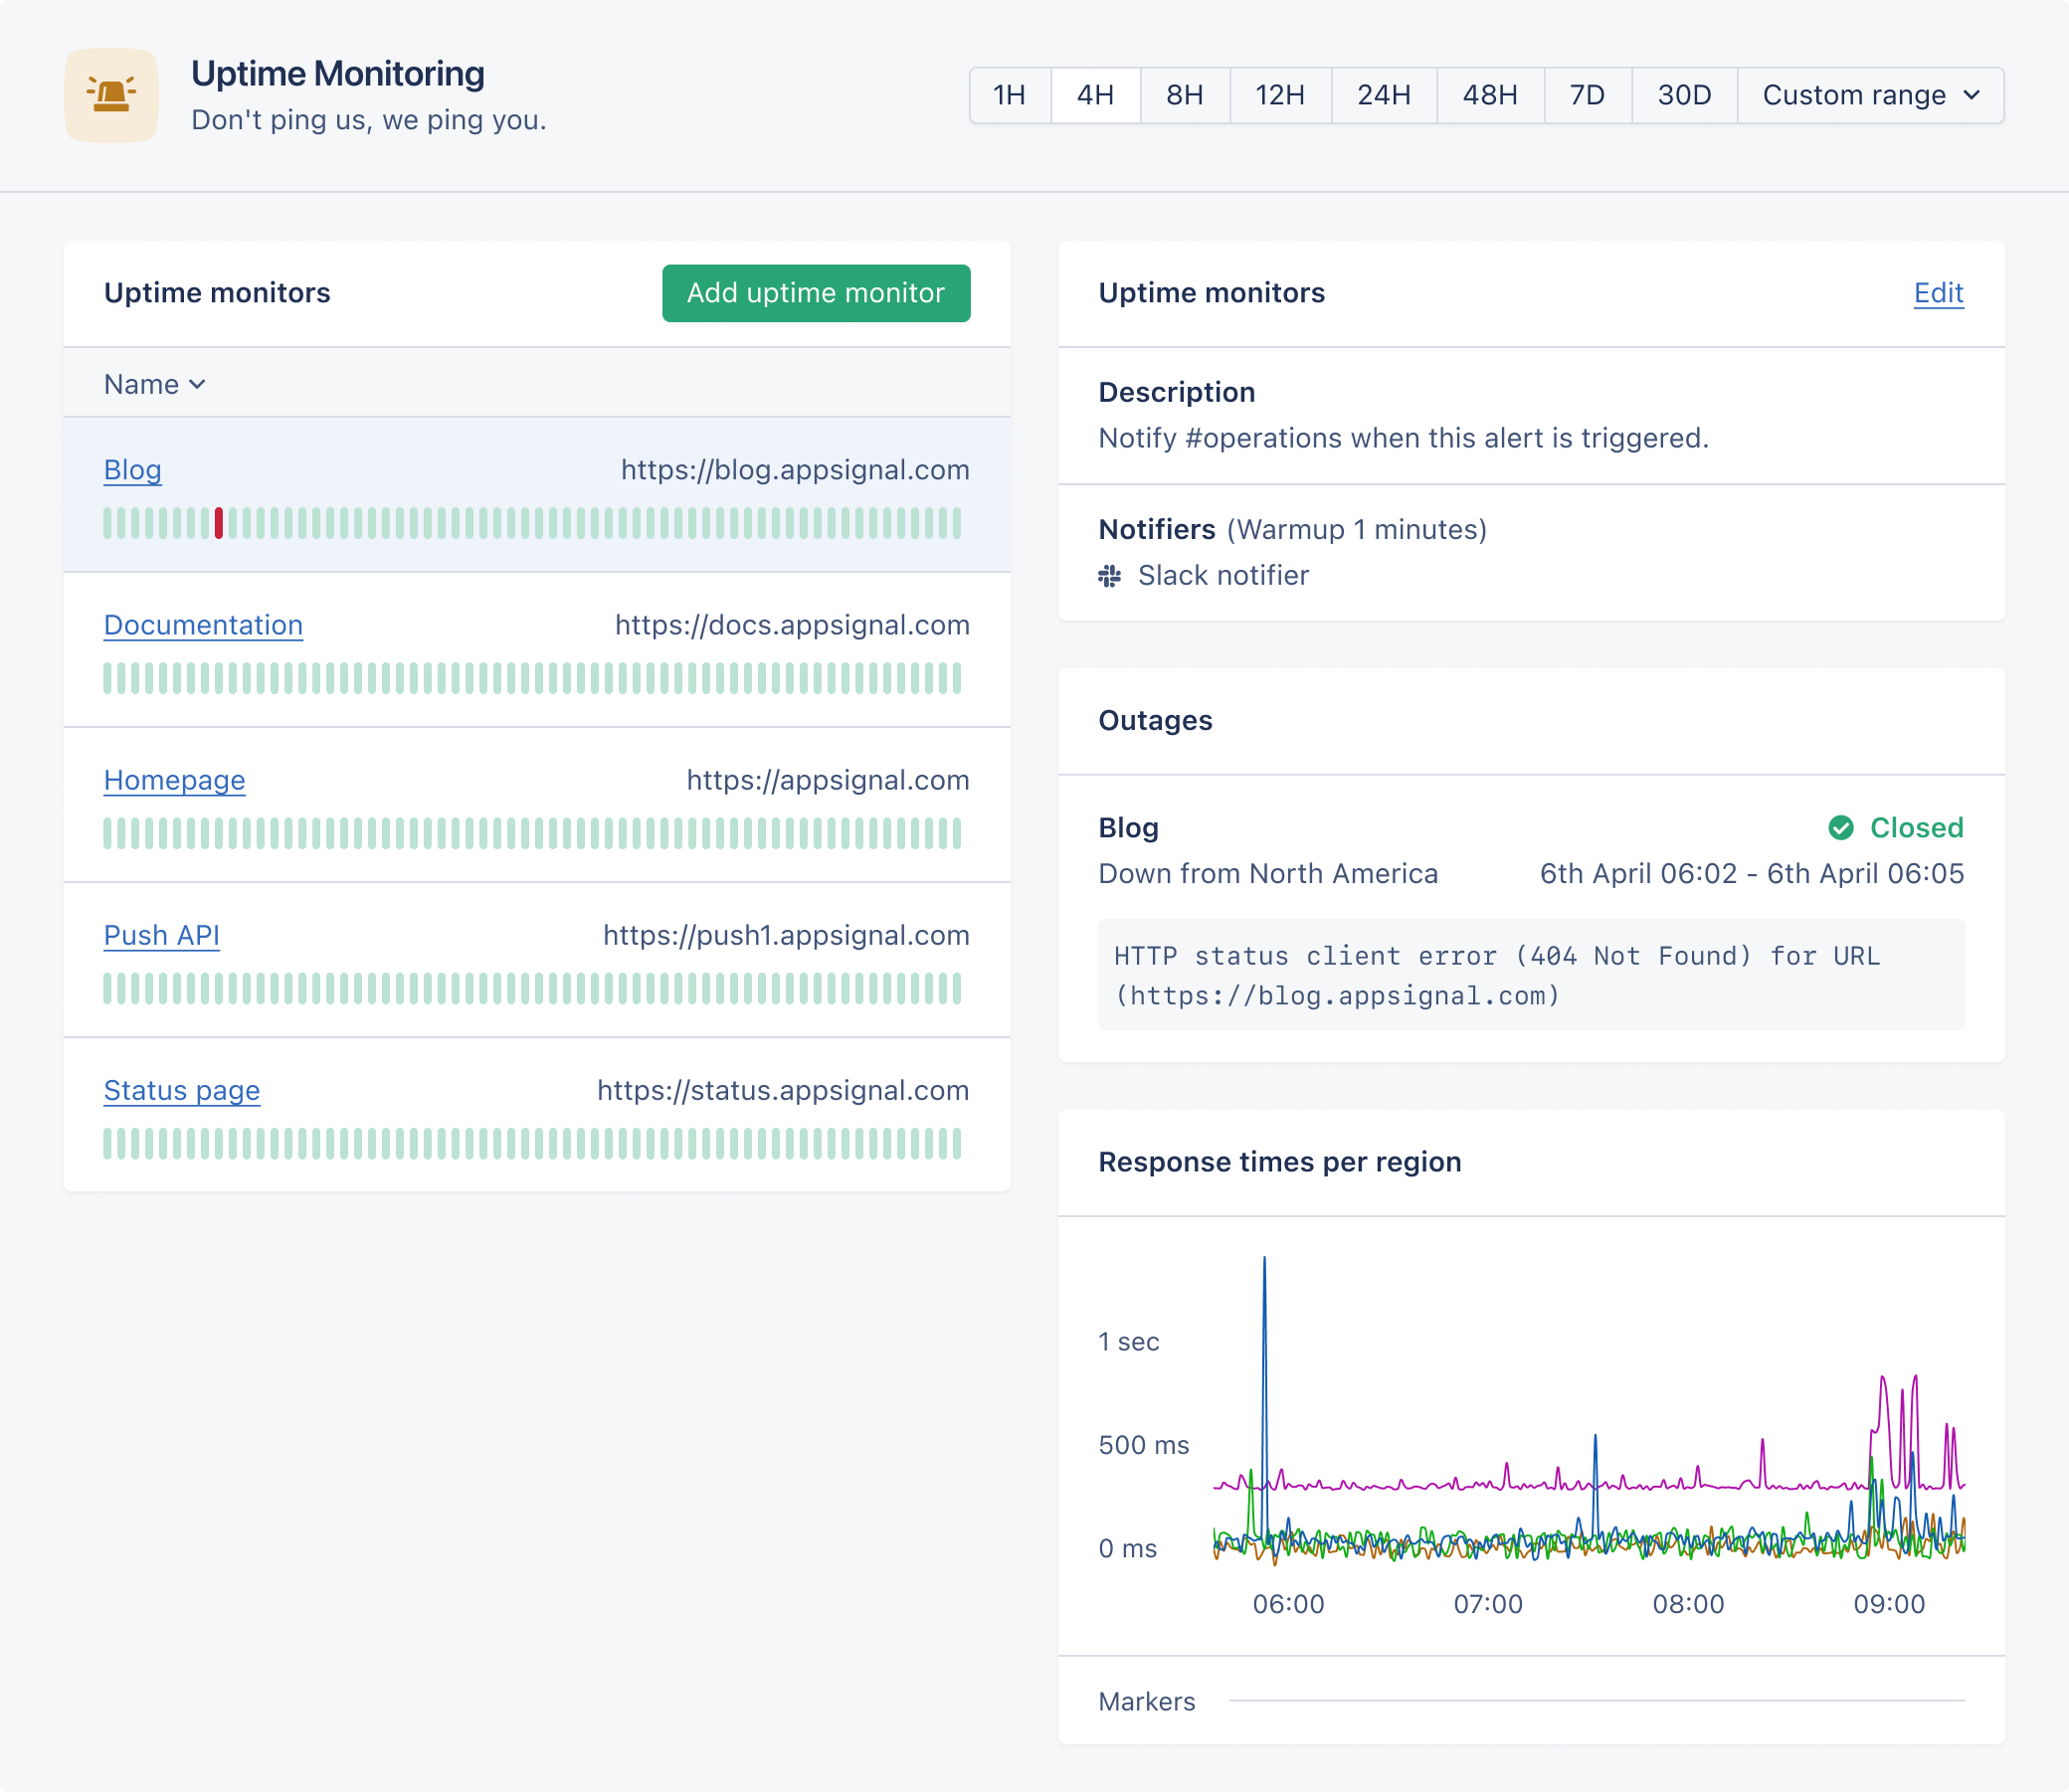
Configuração
Para configurar uma nova verificação de monitor de uptime, clique no botão “Add uptime monitor” na página de Monitoramento de Uptime. Forneça a URL completa (incluindohttp:// ou https://) da página que você gostaria de verificar. Nossos servidores farão uma requisição para essa URL a cada minuto a partir de várias regiões e reportarão se a requisição falhar ou se o código de status da resposta não estiver no intervalo 2xx.
Para receber notificações quando sua aplicação estiver fora do ar, selecione um método de notificação. Para evitar receber alertas em pequenas instabilidades de rede, recomendamos definir um período de warm-up de alerta de pelo menos um minuto.
Você pode definir headers a serem enviados nas requisições que realizamos para a URL fornecida. Isso permite que você defina headers de autorização para permitir que as requisições passem.
Como funciona
Pingamos suas aplicações a partir de workers do AWS Lambda que são executados a partir das seguintes regiões: Faremos requisições à URL fornecida a partir das seguintes regiões:- Ásia-Pacífico (Seul)
- Europa (Frankfurt)
- América do Norte (N. Virginia)
- América do Sul (São Paulo)
User Agent
As requisições do nosso Uptime monitoring para sua aplicação definirão o headerUser-Agent da seguinte forma, onde <version> é um número de versão como 1.0:
Shell
Allowlist de IPs
Executamos nossas verificações de uptime em um framework serverless e não temos controle sobre qual endereço IP será usado para fazer a requisição à sua aplicação. Portanto, não conseguimos fornecer uma lista de endereços IP para colocar em allowlist. A URL a ser monitorada deve estar acessível publicamente a partir da internet aberta.Métricas
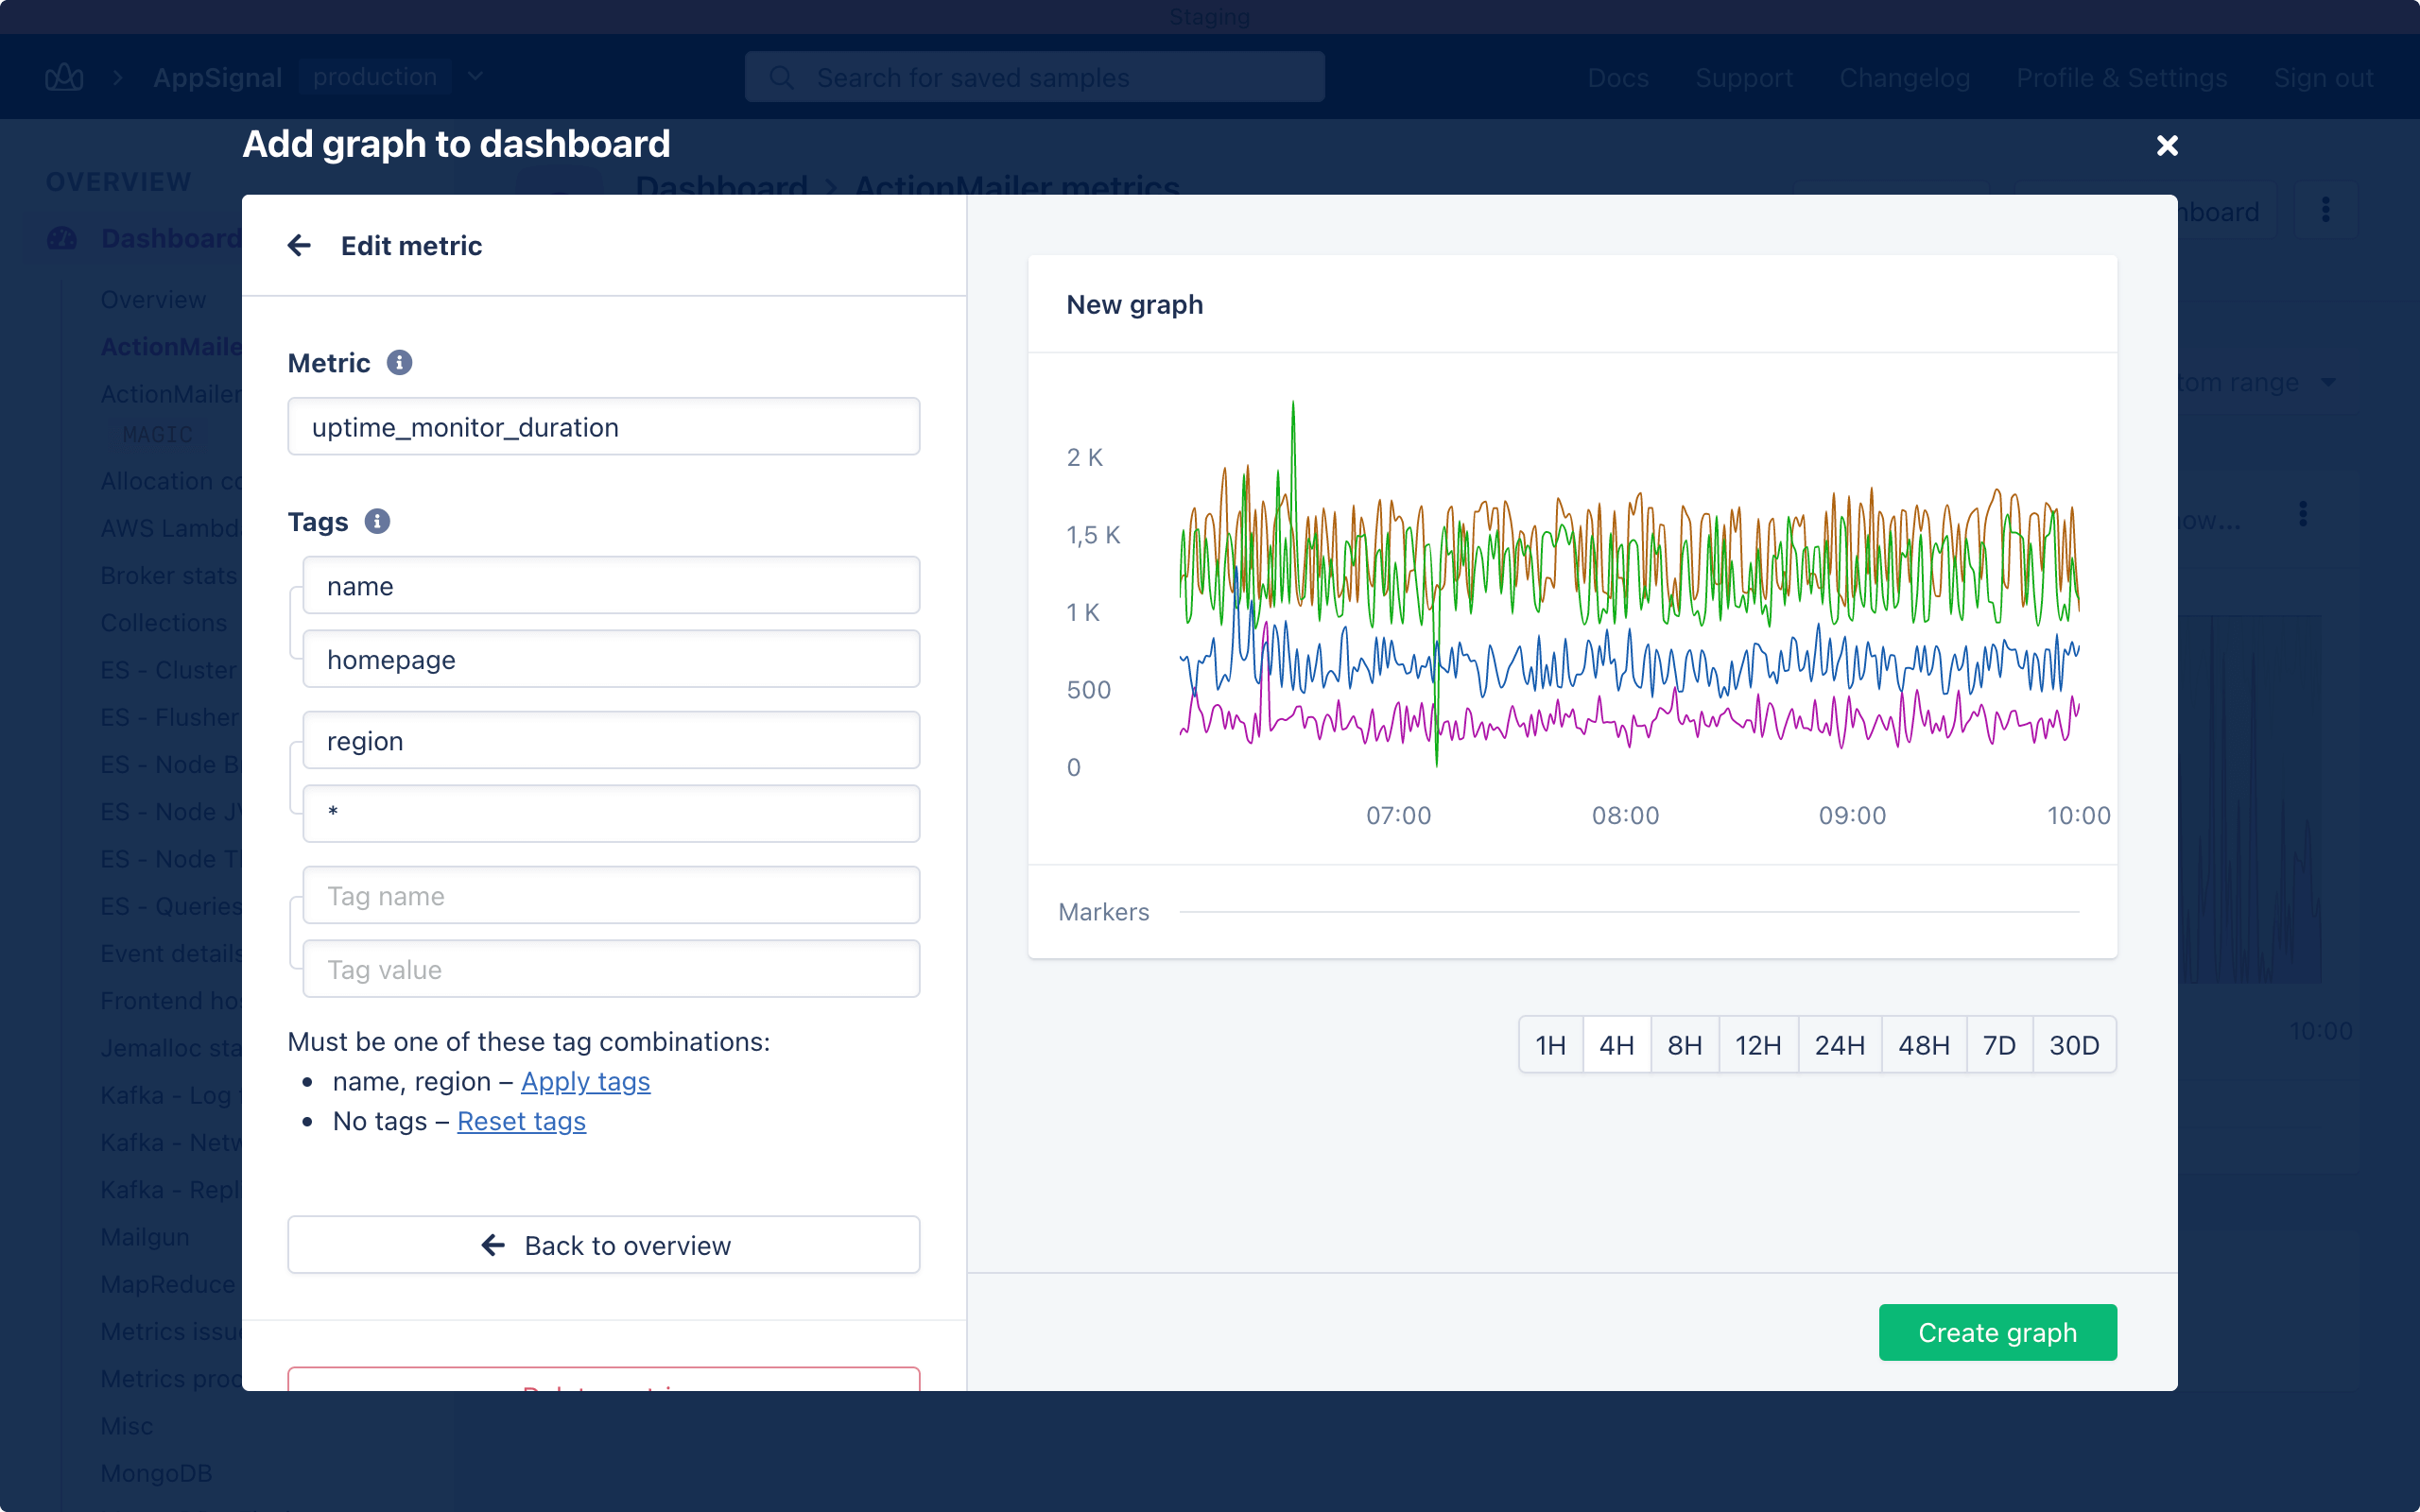
Para cada verificação de monitor de uptime, criamos várias métricas que você pode usar para criar seus próprios gráficos personalizados e definir seus próprios gatilhos de Anomaly detection. Para consultaruptime_monitor_error_count ou uptime_monitor_duration para um monitor específico, use region junto com o name ou o id do monitor. Prefira id, porque o nome de um monitor pode mudar, mas seu id permanece o mesmo. Os valores da tag de região são asia-pacific, europe, north-america e south-america.
Para consultar days_until_ssl_expiration para um monitor específico, use seu name ou id. Essa métrica não usa uma tag region.
Contagem de erros
A métricauptime_monitor_error_count é um contador que, para um determinado minuto, será definido como zero se a requisição for bem-sucedida ou como um se a requisição falhar.
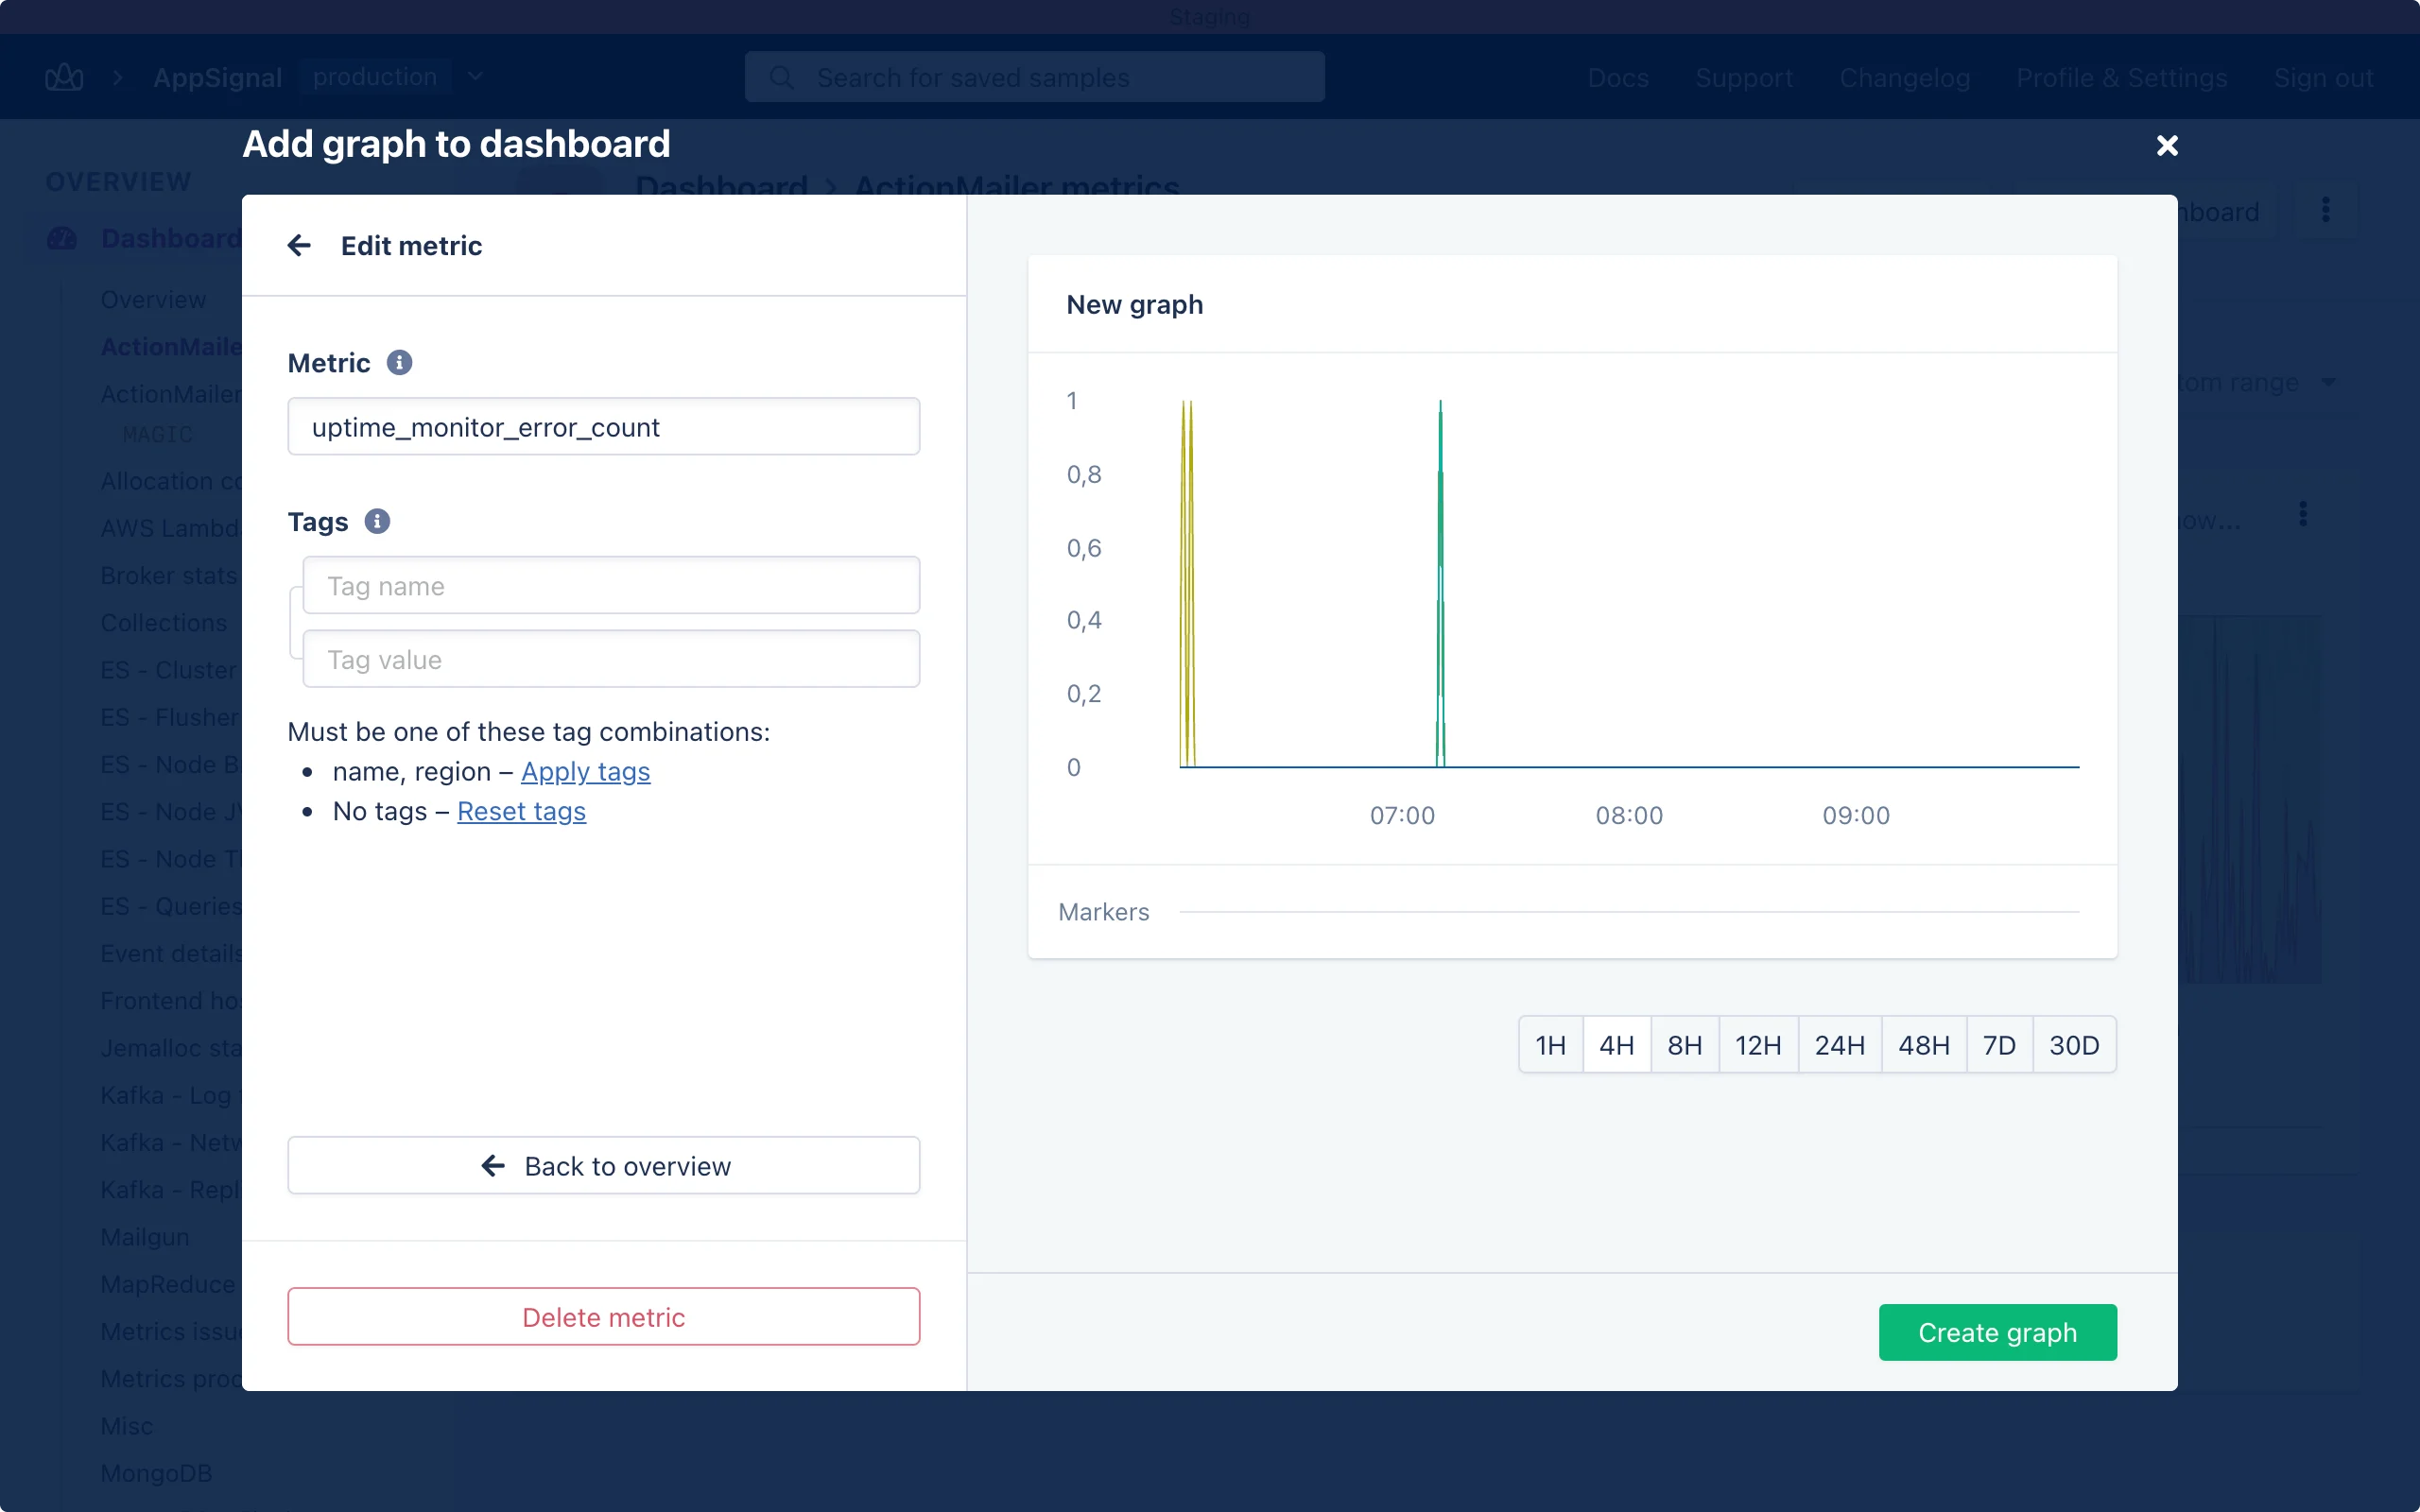
Desempenho do endpoint
A métricauptime_monitor_duration é um gauge que rastreia a duração da requisição para cada região. Isso permite que você veja se a latência para seus servidores está aumentando.
Tempo de requisição
A métricauptime_monitor_timing é um gauge que registra quanto tempo cada fase da requisição levou, em milissegundos. Ela mostra para onde vai o tempo quando um monitor está lento: resolvendo o nome do host, conectando ou aguardando o servidor. Por exemplo, se o ttfb estiver alto mas o dns e o connect estiverem baixos, seu servidor está lento para responder. Se o connect estiver alto apenas em uma região, o problema é o caminho de rede até essa região, não a sua aplicação.
Selecione uma fase com a tag phase:
Se a URL redirecionar, cada fase inclui também as requisições redirecionadas.
Para consultar essa métrica para um monitor específico, use
region, phase e o name ou id do monitor. O app ainda não exibe esses tempos. Consulte-os através da API pública (V2) ou pergunte ao seu agente através do AppSignal MCP.
Planos e Requisições
Se a aplicação que serve a URL usar uma integração do AppSignal, nosso monitor de uptime pode consumir muitas das requisições mensais do seu plano. Recomendamos configurar um endpoint dedicado de health-check e configurar o AppSignal para ignorar requisições a esse endpoint para que elas não contem no limite do seu plano.Exemplo
Aqui está um exemplo de endpoint de health-check em Ruby on Rails. Garantimos atingir todos os nossos serviços externos, como o banco de dados e o Redis, algo que pode não acontecer na página inicial, garantindo que todos os serviços estejam operacionais.ignore_actions: