
Einrichtung
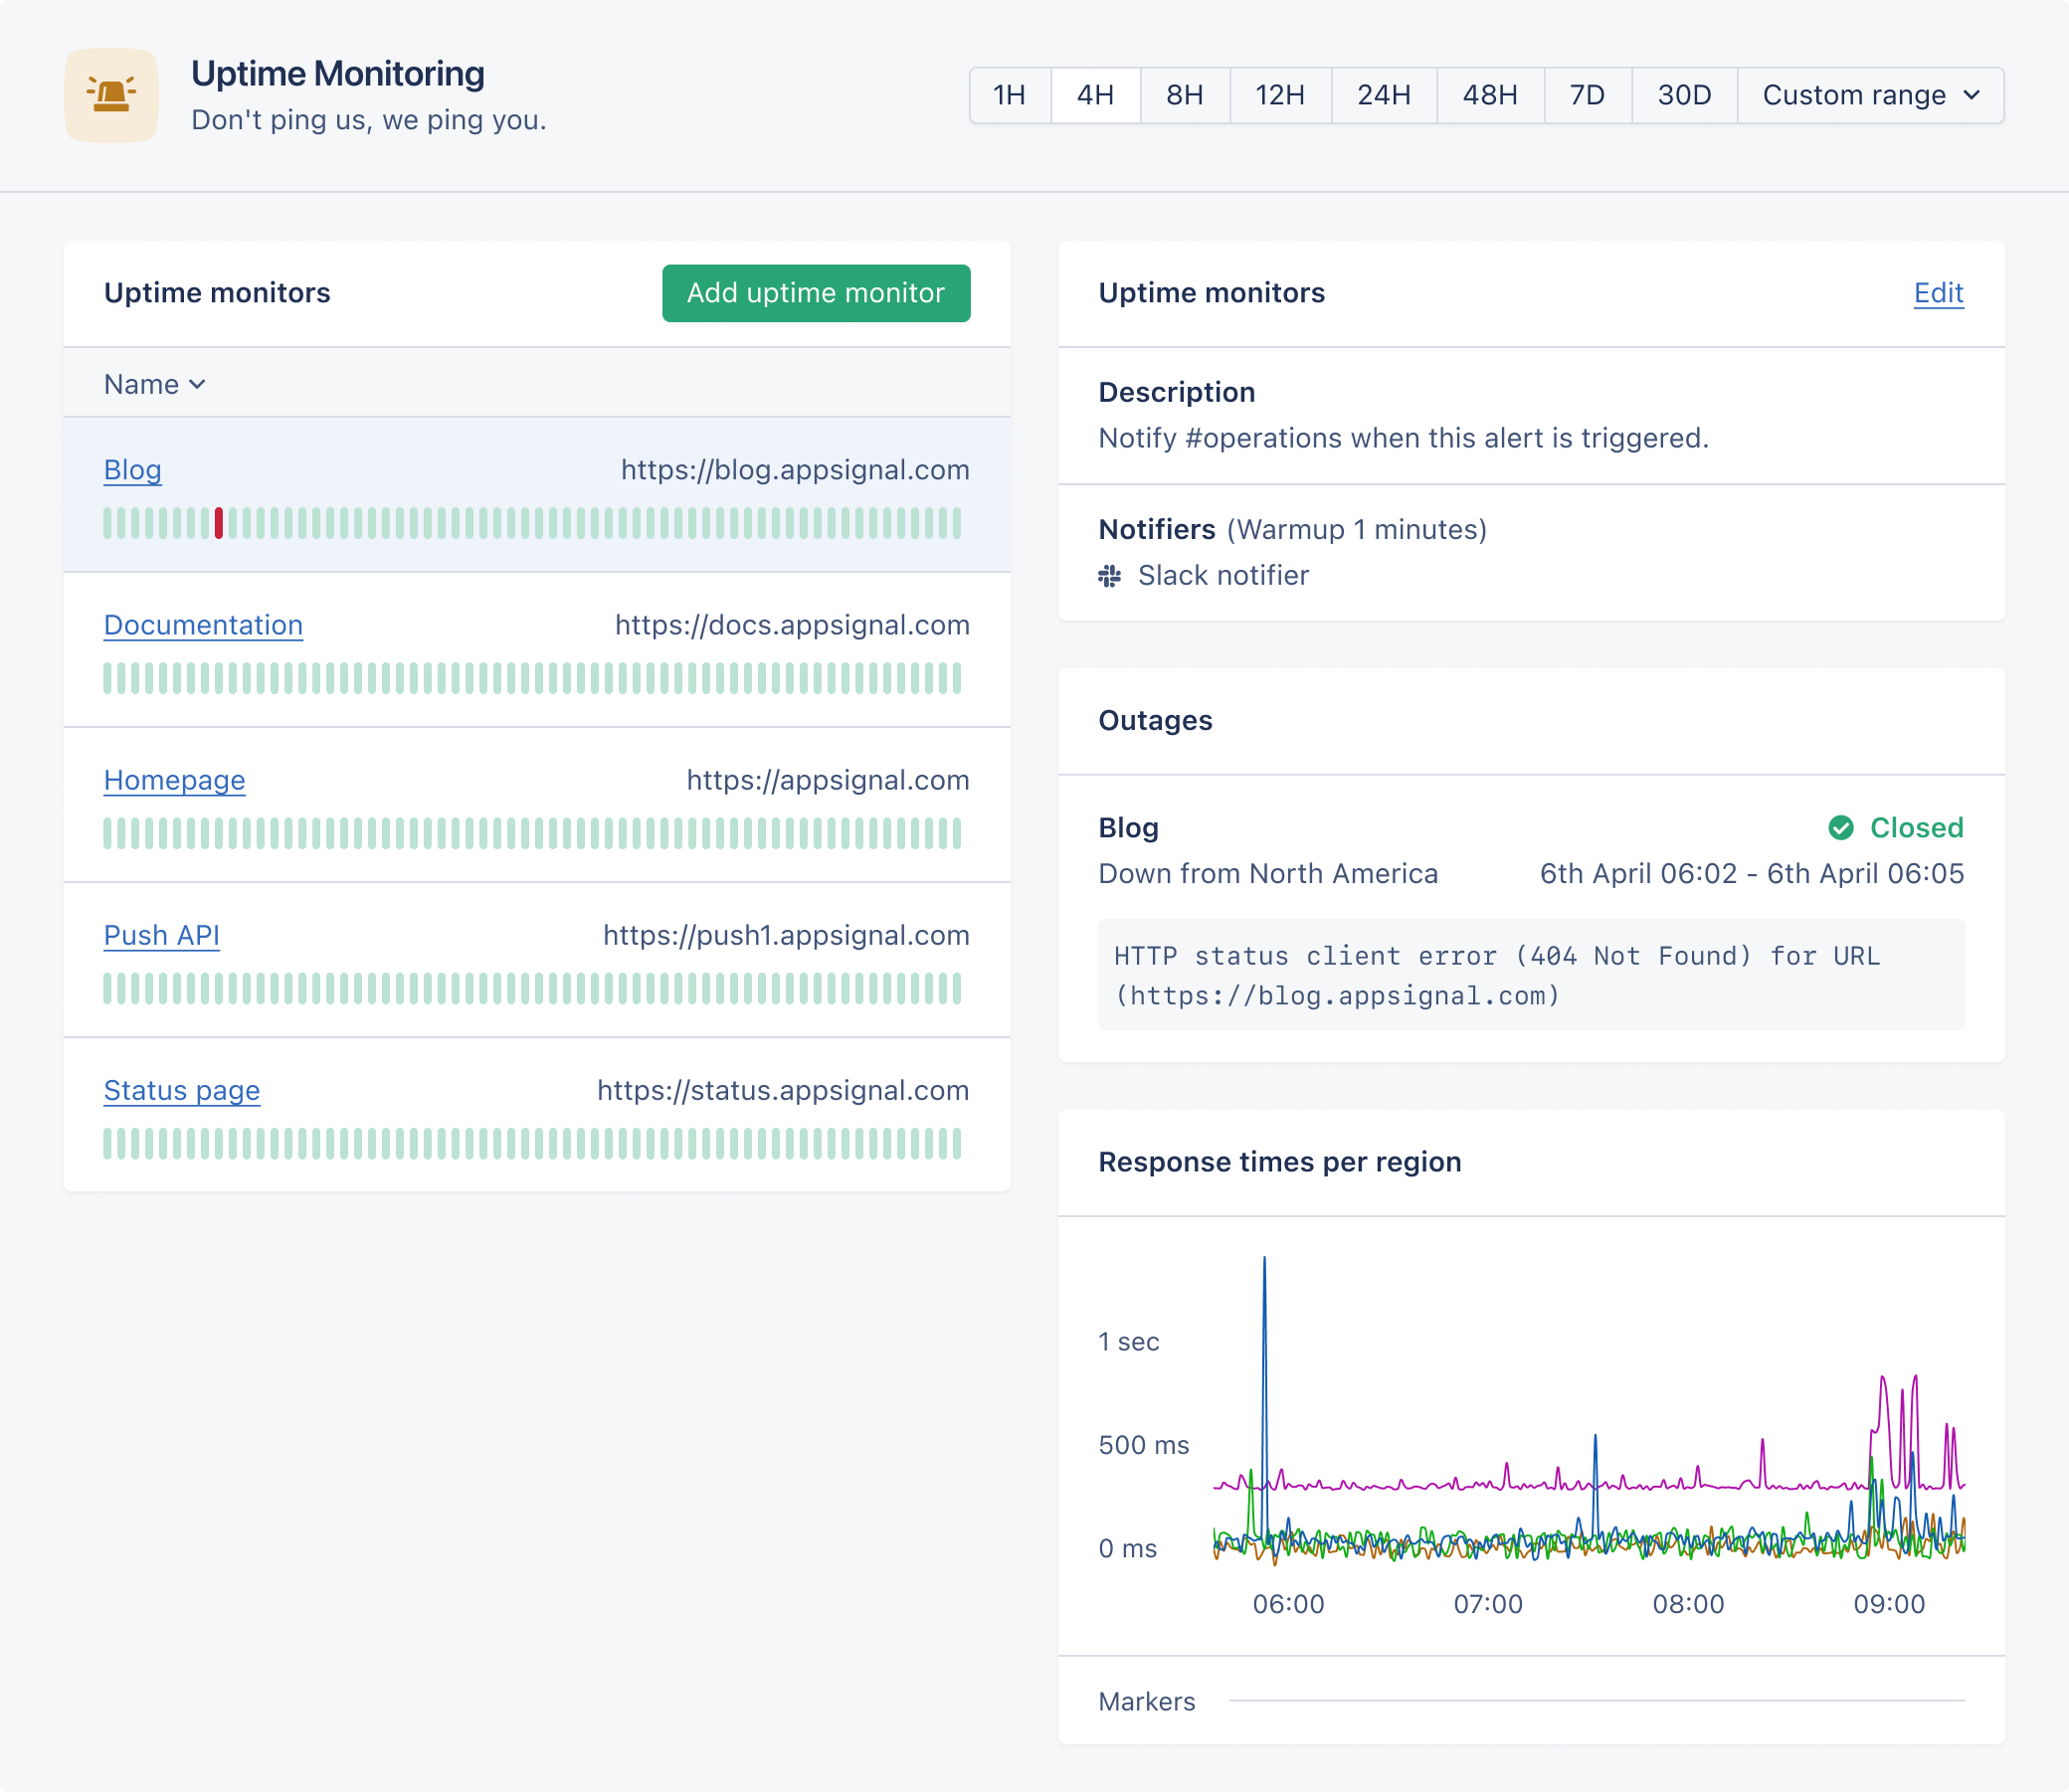
Um eine neue Uptime-Monitor-Prüfung einzurichten, klicken Sie auf der Seite Uptime Monitoring auf die Schaltfläche „Add uptime monitor”. Geben Sie die vollständige URL (einschließlichhttp:// oder https://) der Seite an, die Sie überprüfen möchten. Unsere Server stellen jede Minute eine Anfrage an diese URL aus mehreren Regionen und melden, wenn die Anfrage fehlschlägt oder der Antwortstatuscode nicht im Bereich 2xx liegt.
Um Benachrichtigungen zu erhalten, wenn Ihre Anwendung ausgefallen ist, wählen Sie eine Benachrichtigungsmethode aus. Um zu vermeiden, dass Sie bei kleinen Netzwerkproblemen Benachrichtigungen erhalten, empfehlen wir, eine Alert-Warmup-Periode von mindestens einer Minute einzustellen.
Sie können Header festlegen, die in den Anfragen gesendet werden, die wir an die von Ihnen angegebene URL stellen. Damit können Sie Autorisierungs-Header festlegen, damit die Anfragen durchgehen.
So funktioniert es
Wir pingen Ihre Anwendungen von AWS-Lambda-Workern, die aus den folgenden Regionen ausgeführt werden: Wir fordern die angegebene URL aus den folgenden Regionen an:- Asia-Pacific (Seoul)
- Europe (Frankfurt)
- North America (N. Virginia)
- South America (São Paulo)
User Agent
Unsere Uptime monitoring-Anfragen an Ihre Anwendung setzen denUser-Agent-Header wie folgt, wobei <version> eine Versionsnummer wie 1.0 ist:
Shell
IP-Allowlisting
Wir führen unsere Uptime-Prüfungen auf einem Serverless-Framework aus und haben keine Kontrolle darüber, welche IP-Adresse verwendet wird, um die Anfrage an Ihre Anwendung zu stellen. Daher können wir keine Liste von IP-Adressen zum Allowlisting bereitstellen. Die zu überwachende URL muss vom offenen Internet aus öffentlich erreichbar sein.Metriken
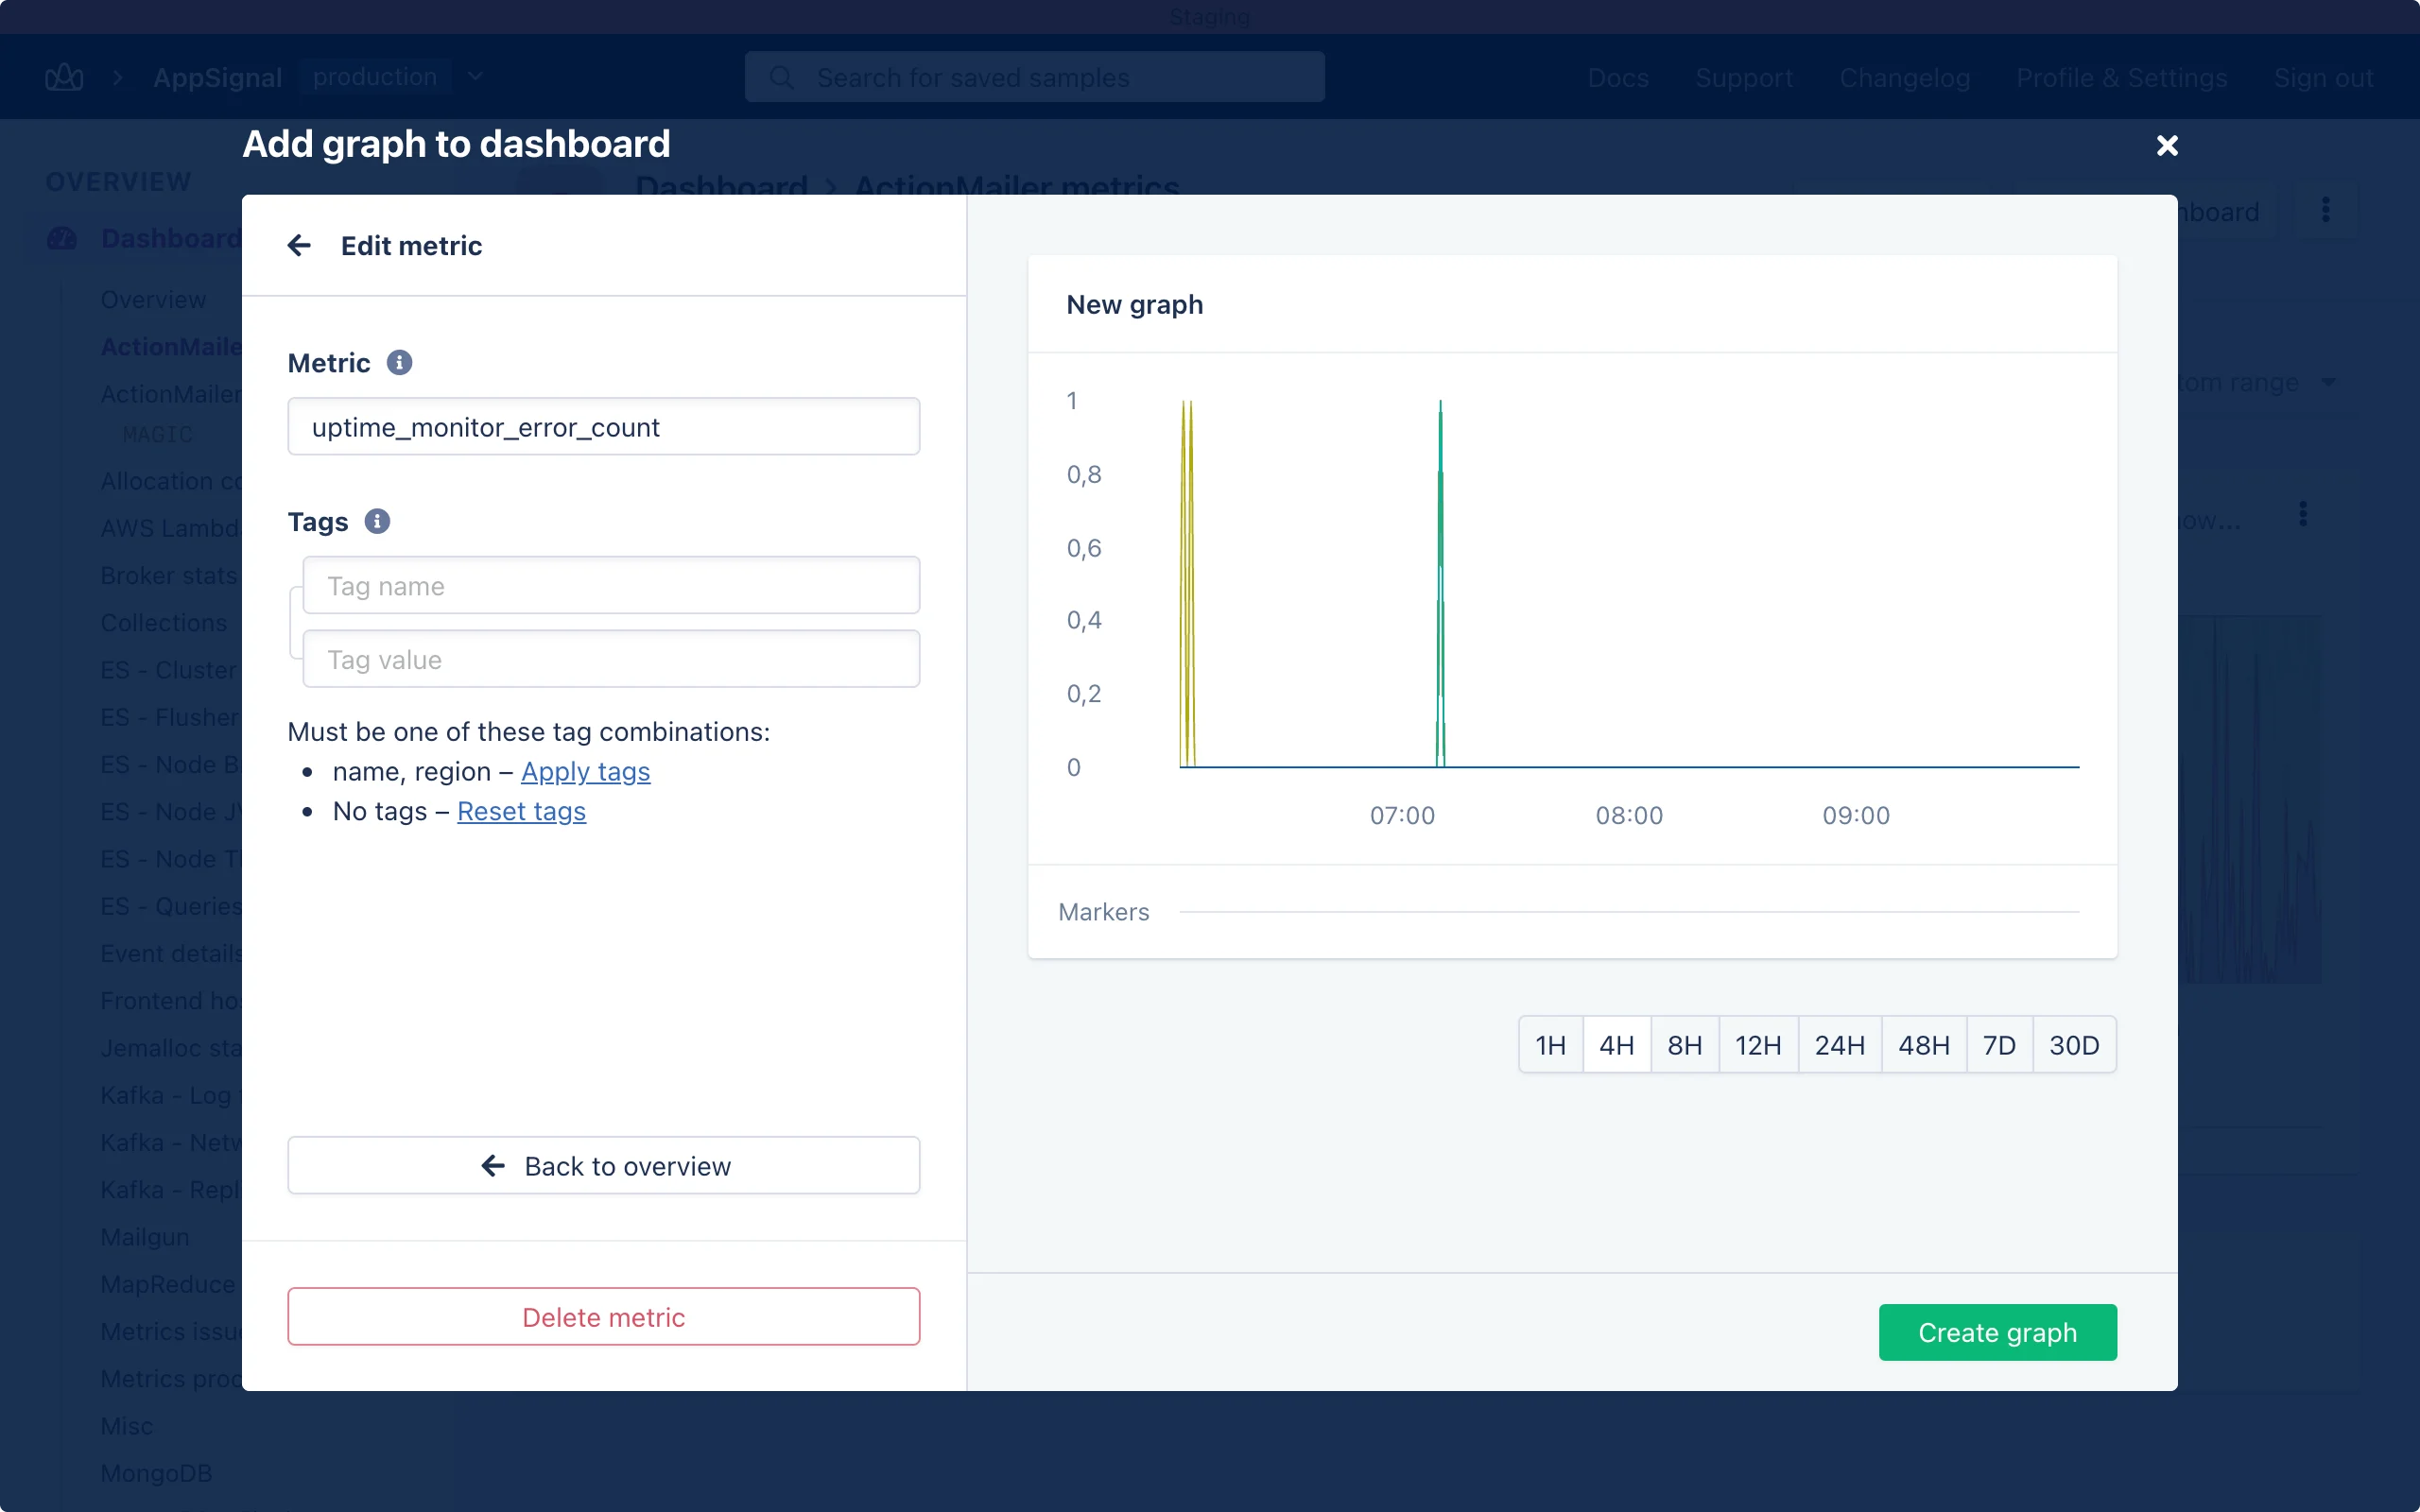
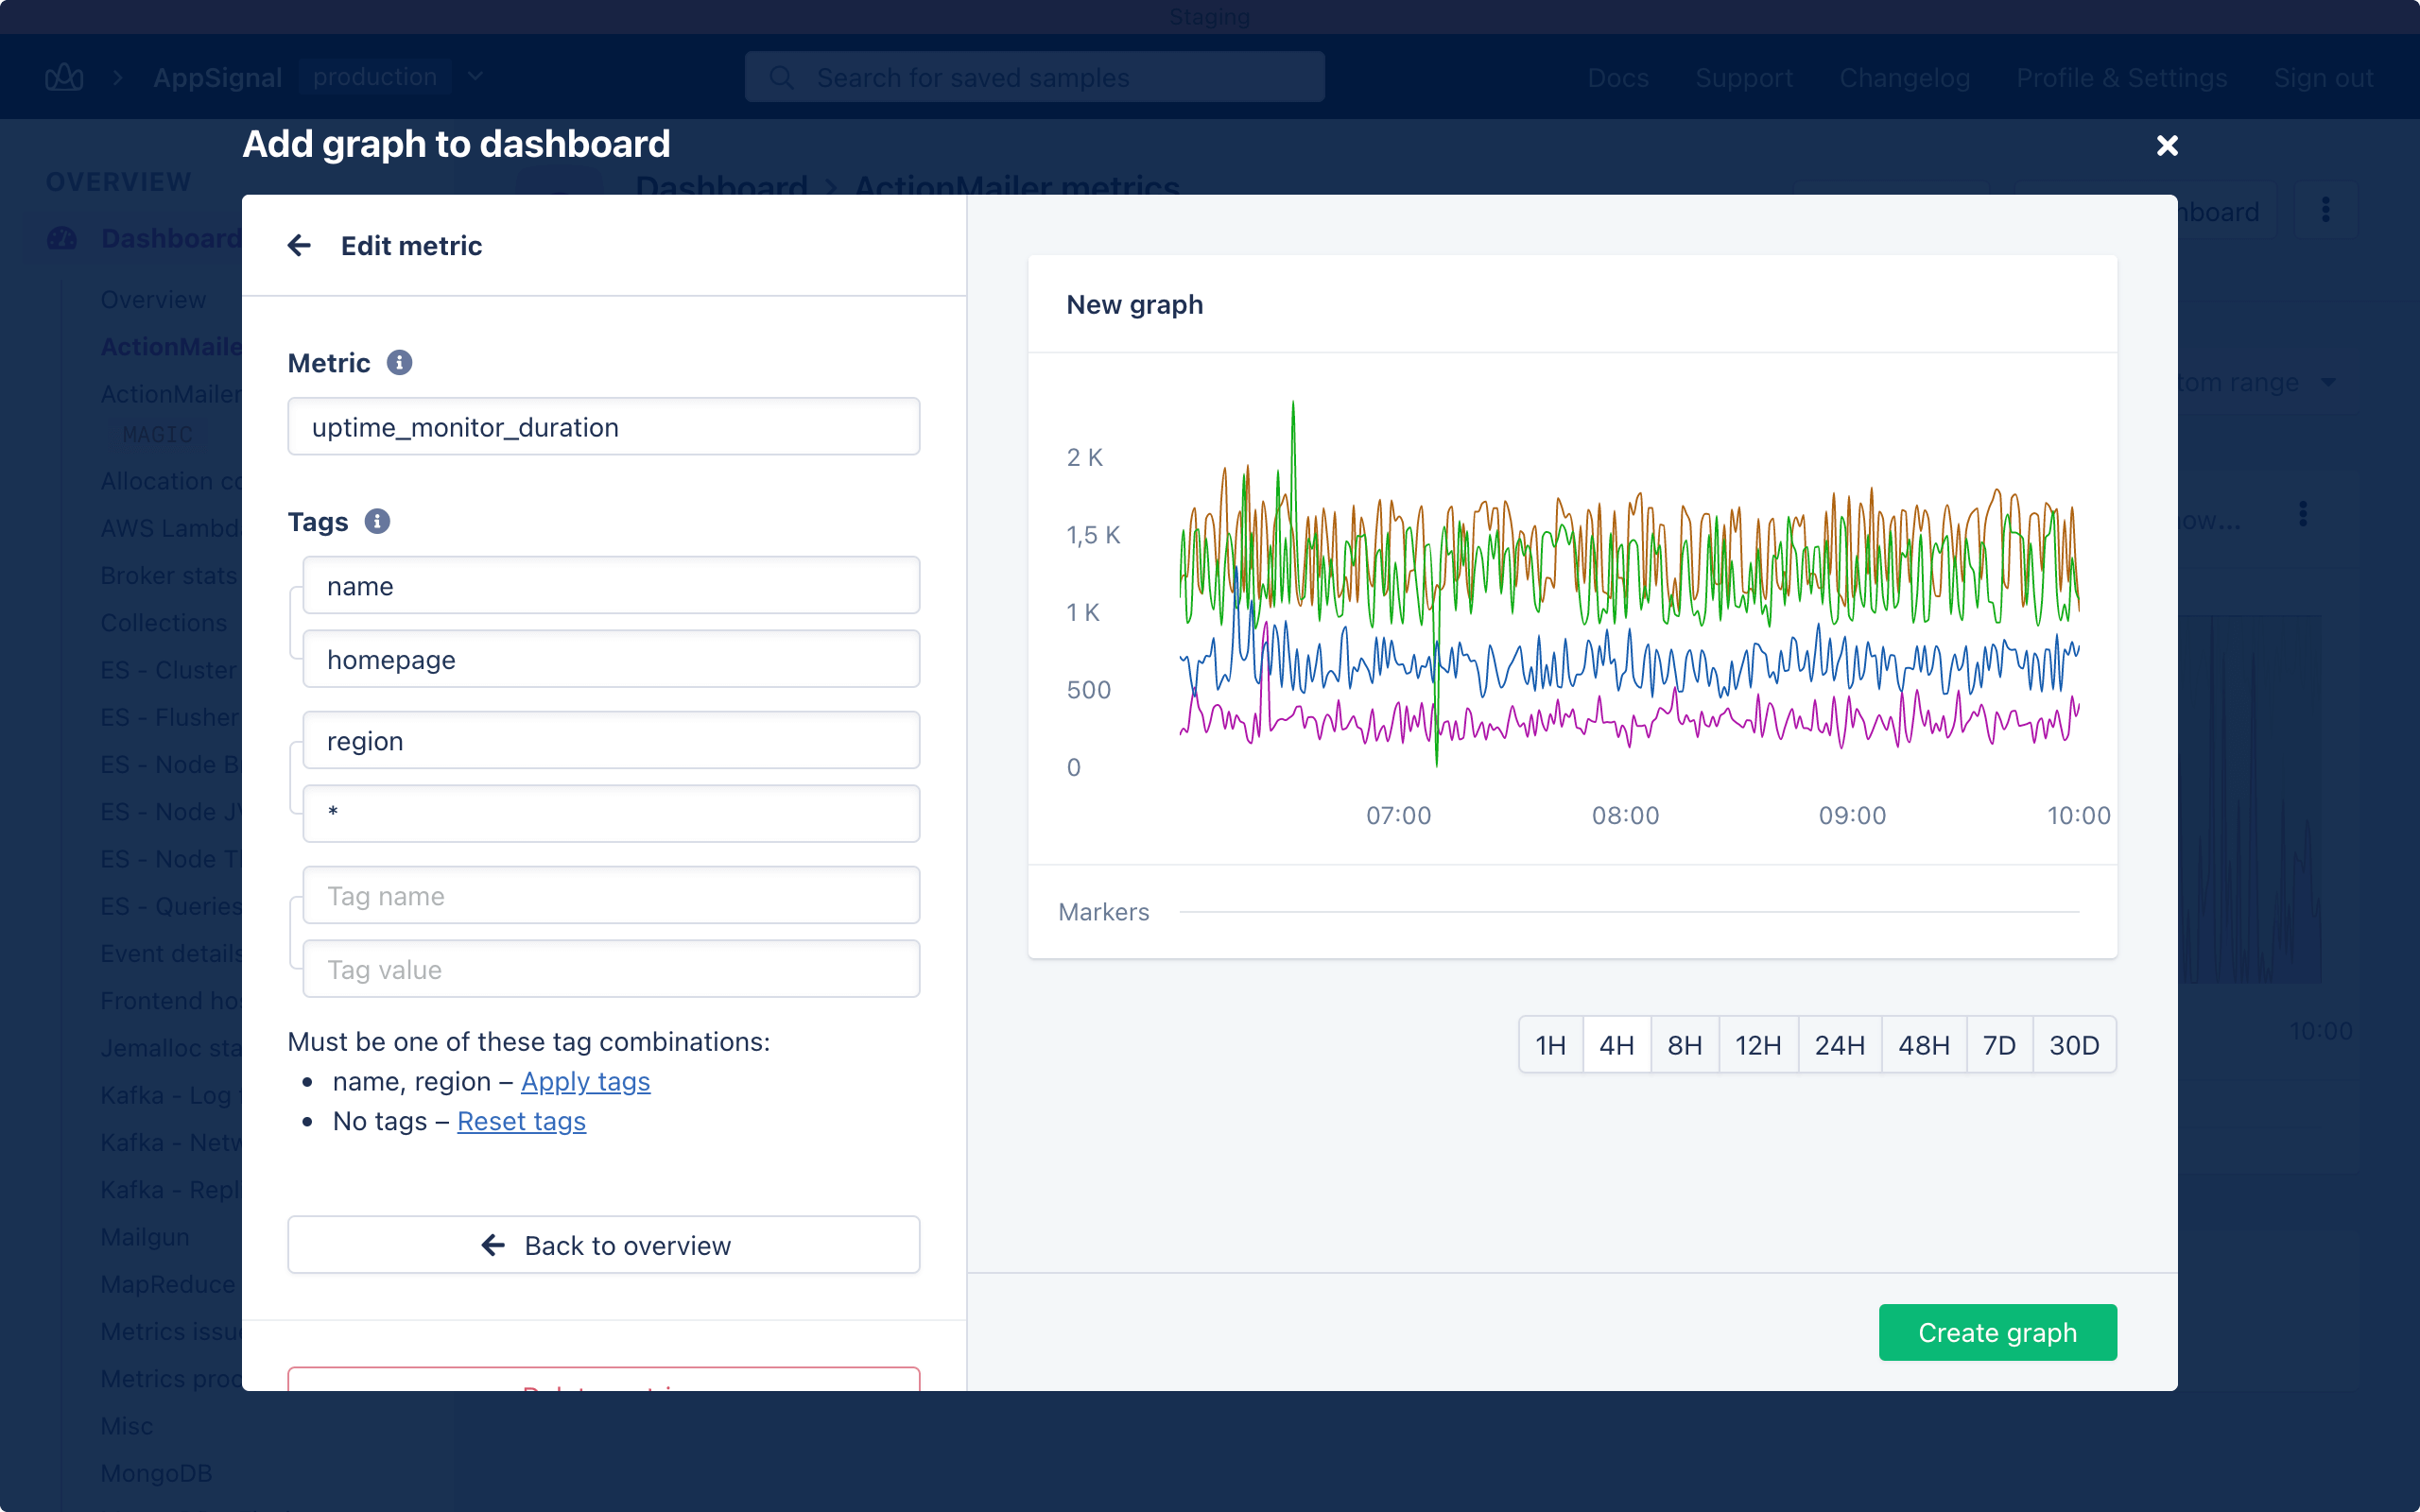
Für jede Uptime-Monitor-Prüfung erstellen wir mehrere Metriken, die Sie verwenden können, um Ihre eigenen benutzerdefinierten Graphen zu erstellen und Ihre eigenen Trigger zur Anomaly detection festzulegen. Umuptime_monitor_error_count oder uptime_monitor_duration für einen bestimmten Monitor abzufragen, verwenden Sie region zusammen mit entweder dem name oder der id des Monitors. Bevorzugen Sie id, da sich der Name eines Monitors ändern kann, seine id jedoch gleich bleibt. Die Werte des Regions-Tags sind asia-pacific, europe, north-america und south-america.
Um days_until_ssl_expiration für einen bestimmten Monitor abzufragen, verwenden Sie dessen name oder id. Diese Metrik verwendet kein region-Tag.
Fehleranzahl
Dieuptime_monitor_error_count-Metrik ist ein Counter, der für eine bestimmte Minute auf Null gesetzt wird, wenn die Anfrage erfolgreich war, oder auf eins, wenn die Anfrage fehlschlägt.
Endpoint-Performance
Dieuptime_monitor_duration-Metrik ist ein Gauge, der die Dauer der Anfrage für jede Region verfolgt. Damit können Sie sehen, ob die Latenz zu Ihren Servern zunimmt.
Anfrage-Timing
Dieuptime_monitor_timing-Metrik ist ein Gauge, der aufzeichnet, wie lange jede Phase der Anfrage gedauert hat, in Millisekunden. Sie zeigt, wo die Zeit verloren geht, wenn ein Monitor langsam ist: beim Auflösen des Hostnamens, beim Verbindungsaufbau oder beim Warten auf den Server. Wenn zum Beispiel ttfb hoch, aber dns und connect niedrig sind, antwortet Ihr Server langsam. Wenn connect nur in einer Region hoch ist, liegt das Problem am Netzwerkpfad zu dieser Region, nicht an Ihrer Anwendung.
Wählen Sie eine Phase mit dem phase-Tag aus:
Wenn die URL weiterleitet, enthält jede Phase auch die weitergeleiteten Anfragen.
Um diese Metrik für einen bestimmten Monitor abzufragen, verwenden Sie
region, phase und entweder den name oder die id des Monitors. Die App zeigt diese Zeitwerte noch nicht an. Fragen Sie sie über die Public API (V2) ab, oder fragen Sie Ihren Agenten über AppSignal MCP.
Pläne und Anfragen
Wenn die Anwendung, die die URL bereitstellt, eine AppSignal-Integration verwendet, kann unser Uptime-Monitor viele der monatlichen Anfragen Ihres Plans verbrauchen. Wir empfehlen, einen dedizierten Health-Check-Endpunkt einzurichten und AppSignal so zu konfigurieren, dass Anfragen an diesen Endpunkt ignoriert werden, damit sie nicht zum Limit Ihres Plans zählen.Beispiel
Hier ist ein Beispiel für einen Health-Check-Endpunkt in Ruby on Rails. Wir stellen sicher, dass wir alle unsere externen Dienste wie die Datenbank und Redis ansprechen, etwas, das auf der Homepage möglicherweise nicht geschieht, um sicherzustellen, dass alle Dienste betriebsbereit sind.ignore_actions verwenden: